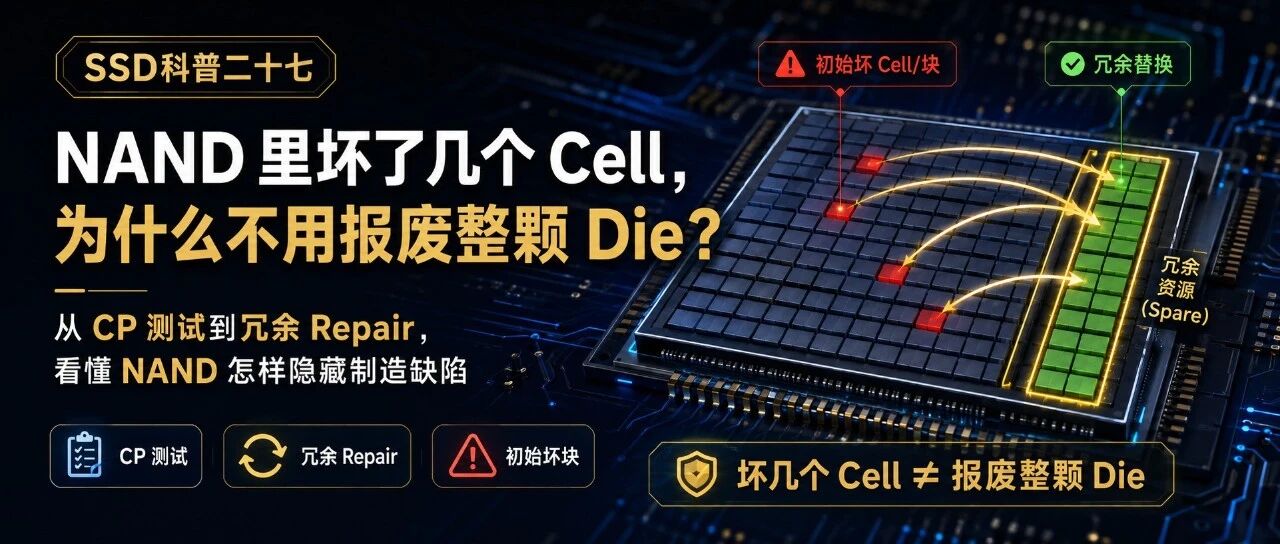
上一篇讲到,NAND 出厂时允许存在少量初始坏块,也就是 Factory Bad Block。
这些坏块会被 NAND 厂商提前写入 Bad Block Marker,也就是 BBM。SSD 初始化 NAND 时,会扫描这些标记,把对应 Block 排除在可用资源之外。
但这里还有一个问题:
如果一颗 Die 在出厂前,只发现一个 Cell、一条 Bitline,或者很小的一片区域存在制造缺陷,难道就要直接放弃整个 Block,甚至淘汰整颗 Die 吗?
其实不会。
在一个 Block 最终被判为初始坏块之前,NAND 内部通常还会先尝试一次 Repair:
使用芯片设计时提前预留的冗余资源,替代存在缺陷的物理资源。
这种设计叫做 Redundancy,也就是冗余设计。
不过,这里所说的 Repair,并不是把已经失效的 Cell 或 Bitline 重新修好。
更准确地说,是停止使用原来的故障资源,再让健康的冗余资源接替它。
就像汽车爆胎以后,并不是让坏轮胎继续工作,而是换上提前准备好的备胎。
一、为什么 NAND 必须提前准备冗余资源?
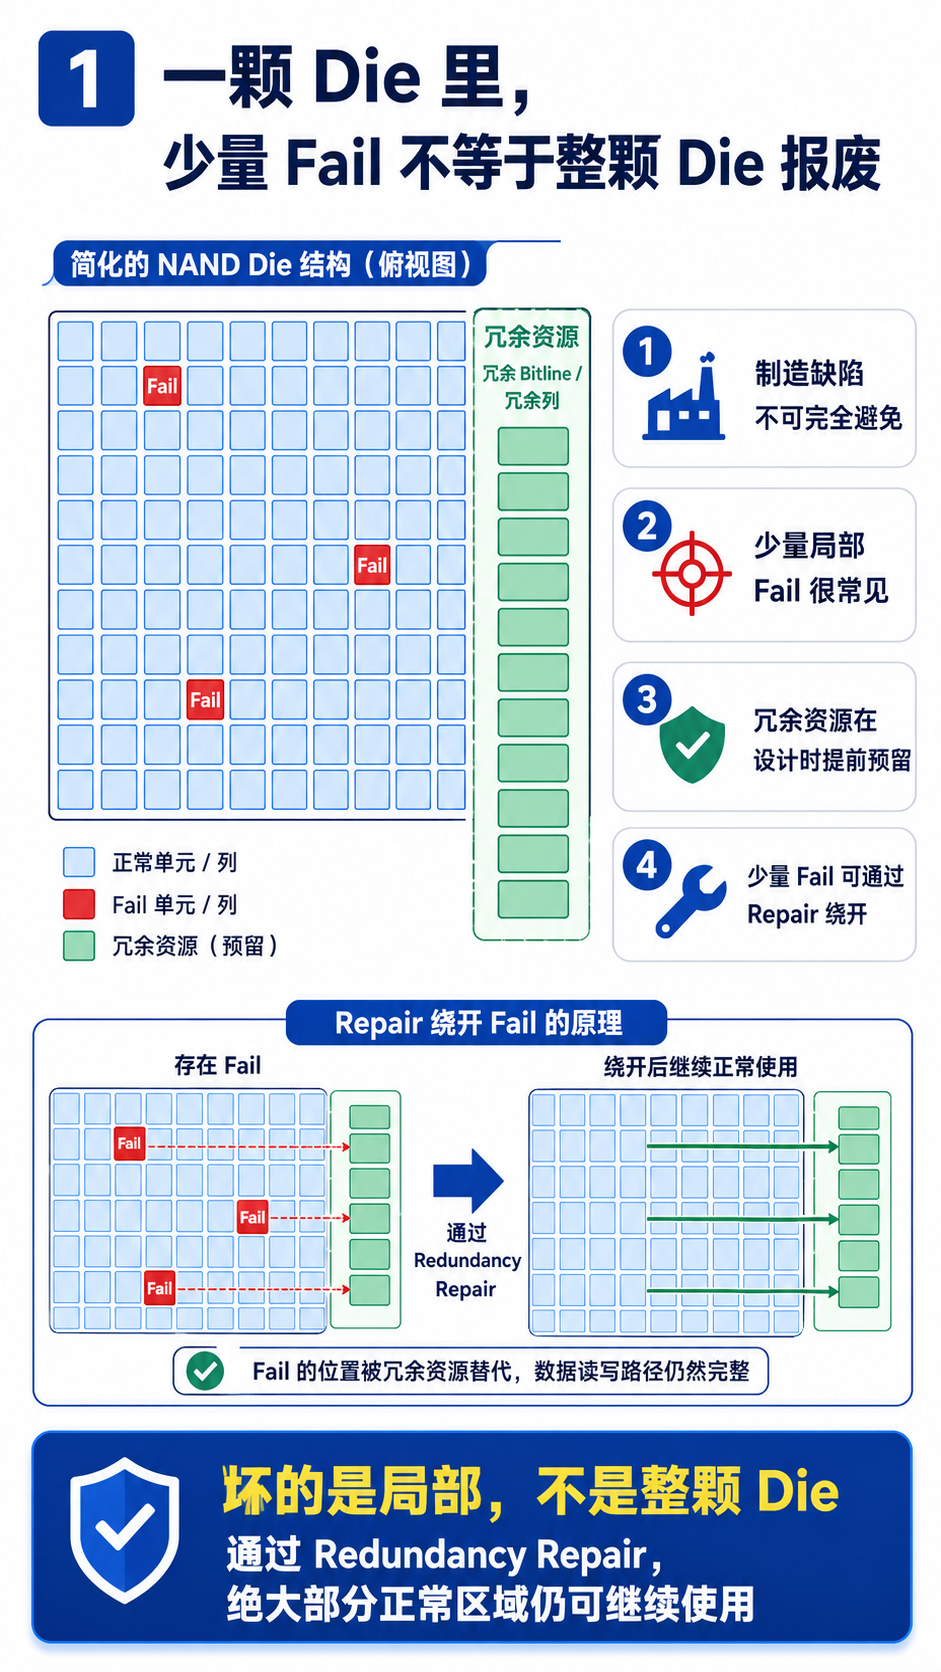
一颗 NAND Die 内部包含数量极其庞大的 Cell。
除了 Cell,还有密集排列的 Wordline、Bitline、接触结构、Page Buffer、译码电路和其他外围电路。
这些结构需要经过多道复杂的制造工艺才能形成。即使工艺已经很成熟,也很难保证如此庞大的结构全部毫无瑕疵。
制造过程中可能出现各种局部问题。
例如:
• 某个 Cell 无法正常 Program; • 某个 Cell 擦除后仍然达不到目标状态; • 某处接触结构没有正常导通; • 相邻 Bitline 之间发生短路; • 某条 Bitline 上的部分 Cell 无法可靠工作; • 某些局部外围电路出现异常。
这些问题和 NAND 使用多年后出现的磨损不同。
P/E Cycle、Retention、Read Disturb,主要发生在 NAND 投入使用以后。
而这里讨论的,是晶圆刚制造完成时,CP 测试就能够发现的制造缺陷。
假如一颗 Die 中只要有一个 Cell 不正常,就必须把整颗 Die 淘汰,那么随着容量越来越大,一颗 Die 做到“处处完美”的概率会越来越低。
最终会出现两个结果:
一是晶圆上能够正常出货的 Die 数量减少。
二是每颗 NAND 的制造成本明显上升。
所以,NAND 从设计之初就不能只考虑:
怎样让所有物理结构绝对不出问题?
它还必须考虑:
如果只有少量局部结构存在缺陷,能不能把这些缺陷绕开,让其余绝大部分正常区域继续使用?
这就是冗余设计存在的意义。
冗余资源并不是测试发现缺陷以后才临时增加的,而是在芯片设计阶段就已经提前预留。
例如,正常阵列旁边可以预留少量冗余 Bitline、冗余列,或者其他能够接替故障资源的结构。
CP 测试发现 Fail 以后,再从这些冗余资源中分配一部分,完成 Repair。
二、冗余 Repair 和 ECC,不是在解决同一个问题
提到 NAND 的可靠性,很多人首先想到的是 ECC。
但冗余 Repair 和 ECC 解决的问题并不相同。
ECC 主要处理数据错误。
例如 NAND 原本保存了一串数据,读取时其中几个 Bit 发生变化。ECC 会利用额外的校验信息,判断错误是否仍在纠错能力范围内,并尝试恢复原始数据。
冗余 Repair 处理的则是物理资源本身的缺陷。
如果 CP 测试已经确认某个 Cell、某条 Bitline 或某组列存在永久性问题,那么与其让 ECC 在今后的每一次读取中都为同一个硬缺陷反复纠错,不如直接停止使用这部分资源,改用冗余资源。
可以简单理解为:
ECC 是把读错的数据纠正回来;
冗余 Repair 是把有问题的物理通路换掉。
当然,两者的边界也不是完全割裂的。
例如,保存 Repair 信息的配置区本身也可能发生 Bit Error,因此这些关键配置仍然需要额外保护。
更准确地说:
冗余 Repair 主要处理 CP 测试阶段已经被定位的硬缺陷,ECC 主要处理数据读取过程中仍然出现的随机错误。
两者处在不同层次,共同保证 NAND 的可靠性。
这里还要注意一点:
行业里所说的 Repair,不代表原来的缺陷真的被“修好了”。
假设某条 Bitline 已经短路,Repair 并不会让它恢复正常,而是让 NAND 以后不再使用这条 Bitline。
所以 Repair 的本质是:
用冗余资源替代 Fail 资源,并把原来的故障路径从正常访问中屏蔽掉。
三、CP 测试怎样找到制造缺陷?
晶圆制造完成后,并不会立即被切割和封装。
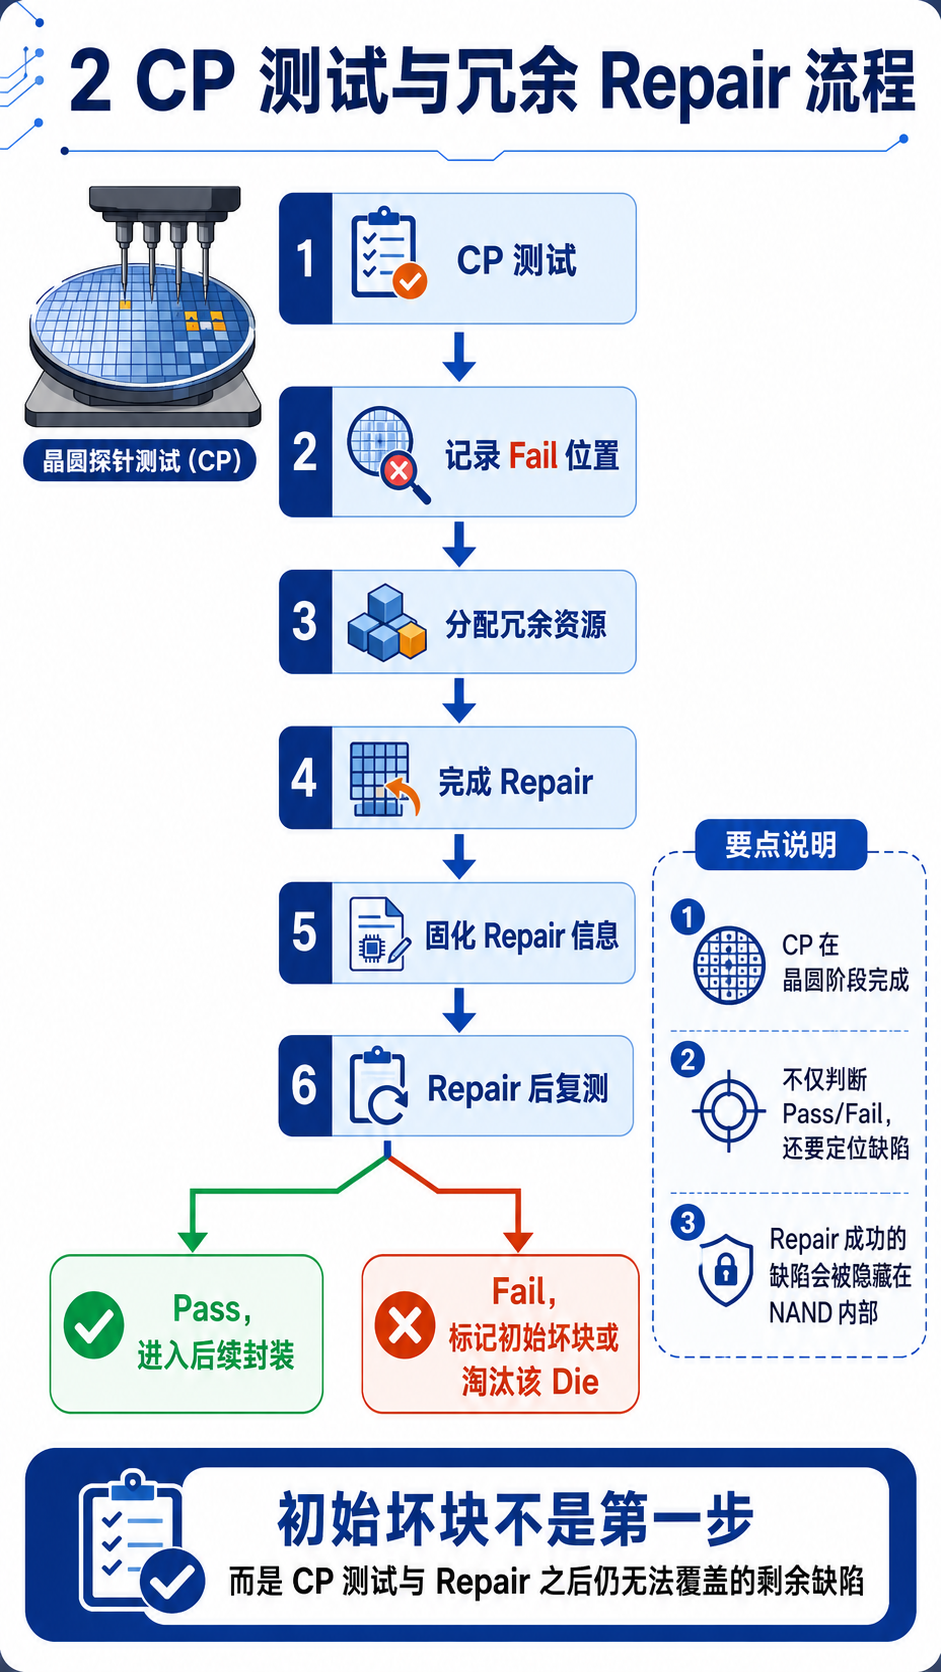
在晶圆阶段,测试设备会通过探针连接晶圆上的每颗 Die,对其进行 CP 测试。
CP 测试可以理解成 NAND 在进入封装前的一次全面体检。
测试设备会执行不同的 Erase、Program 和 Read 操作,同时配合不同的数据 Pattern、地址范围和测试条件,对 NAND Array 和外围电路进行检查。
测试过程中如果出现异常,系统会记录对应的 Fail 信息。
但 CP 测试的目的不只是判断:
这颗 Die 是 Pass,还是 Fail?
它还需要进一步确认:
• Fail 出现在哪个位置; • 是单 Cell Fail、Bitline Short,还是其他结构异常; • 当前缺陷能否使用冗余资源完成 Repair; • 应该分配哪一组 Repair Resource; • Repair 完成以后重新测试,是否能够满足规格。
因此,CP 测试更像是:
先找到故障位置,再分配冗余资源,最后重新验证 Repair 是否有效。
如果 Repair 后重新测试通过,这些制造缺陷就会被隐藏在 NAND 内部,该 Die 可以继续进入后续封装流程。
如果 Repair 以后仍然失败,或者 Fail 数量已经超出冗余资源的覆盖能力,那么对应 Block 可能被标记为 Factory Bad Block。
问题更加严重时,整颗 Die 会被判 Fail,不能继续出货。
所以,出厂坏块并不是制造缺陷出现后的第一步。
真正的流程通常是:
CP 测试发现 Fail
→ 记录 Fail 位置
→ 分配冗余资源
→ 完成 Repair
→ 固化 Repair 信息
→ Repair 后复测
→ 测试通过,进入后续封装
→ 测试失败,标记初始坏块或淘汰该 Die
上一篇看到的初始坏块,其实已经是内部尝试过 Repair 以后,仍然无法被吸收的剩余缺陷。
四、为什么一个 Cell Fail,可能要替换整条 Bitline?
这里有一个容易产生疑问的地方。
如果只坏了一个 Cell,为什么不直接替换这个 Cell,而可能要替换整条 Bitline,甚至一组 Bitline?
因为 NAND Cell 不是一个可以单独拆卸的小零件。
它和 NAND String、Bitline、Page Buffer 以及列选择电路之间已经形成固定连接。
如果每个 Cell 都准备一套独立的替换开关,那么需要的地址记录、控制开关和连接线路会非常庞大。
因此,实际 Repair 通常按照芯片内部的数据通路进行。
Repair 的单位可能是:
• 一条 Bitline; • 一对 Bitline; • 几条 Bitline 组成的一组; • 或者更大的数据单位。
具体使用多大的 Repair 粒度,要看 NAND 内部怎样设计。
从资源利用率来看,Repair 粒度越细,似乎越节省。
假设只有一条 Bitline 存在问题。
如果按照单条 Bitline Repair,只需要消耗一份冗余资源。
如果按照两条 Bitline 为一组进行 Repair,那么旁边原本正常的 Bitline 也可能被一起替换,看上去会浪费一部分资源。
但 Repair 粒度越细,电路也越复杂。
芯片需要更加精确地记录:
• 具体哪条 Bitline 出现 Fail; • 它位于哪个区域; • 应该由哪条冗余 Bitline 接替; • Read 时怎样把冗余数据放回正确位置; • Program 时怎样把输入数据送往冗余资源。
使用较大的 Repair 粒度,虽然可能会连带替换一部分正常资源,但地址记录更简单,数据选择电路也更容易实现。
而且,不同缺陷适合不同的 Repair 方式。
如果只是单 Cell Fail,细粒度 Repair 通常更加节省资源。
但如果是相邻 Bitline 之间发生短路,一次缺陷可能同时影响多条 Bitline。这时按一对或一组进行 Repair,反而可能更加高效。
所以,Repair 粒度不是越小越先进。
真正需要考虑的是:
哪一种缺陷最常见,以及要用多大的芯片面积和电路复杂度去覆盖它。
这也是芯片设计里非常典型的取舍:
粒度越细,资源利用率越高;
粒度越粗,电路实现越简单。
五、Repair 以后,外部地址为什么不用改变?
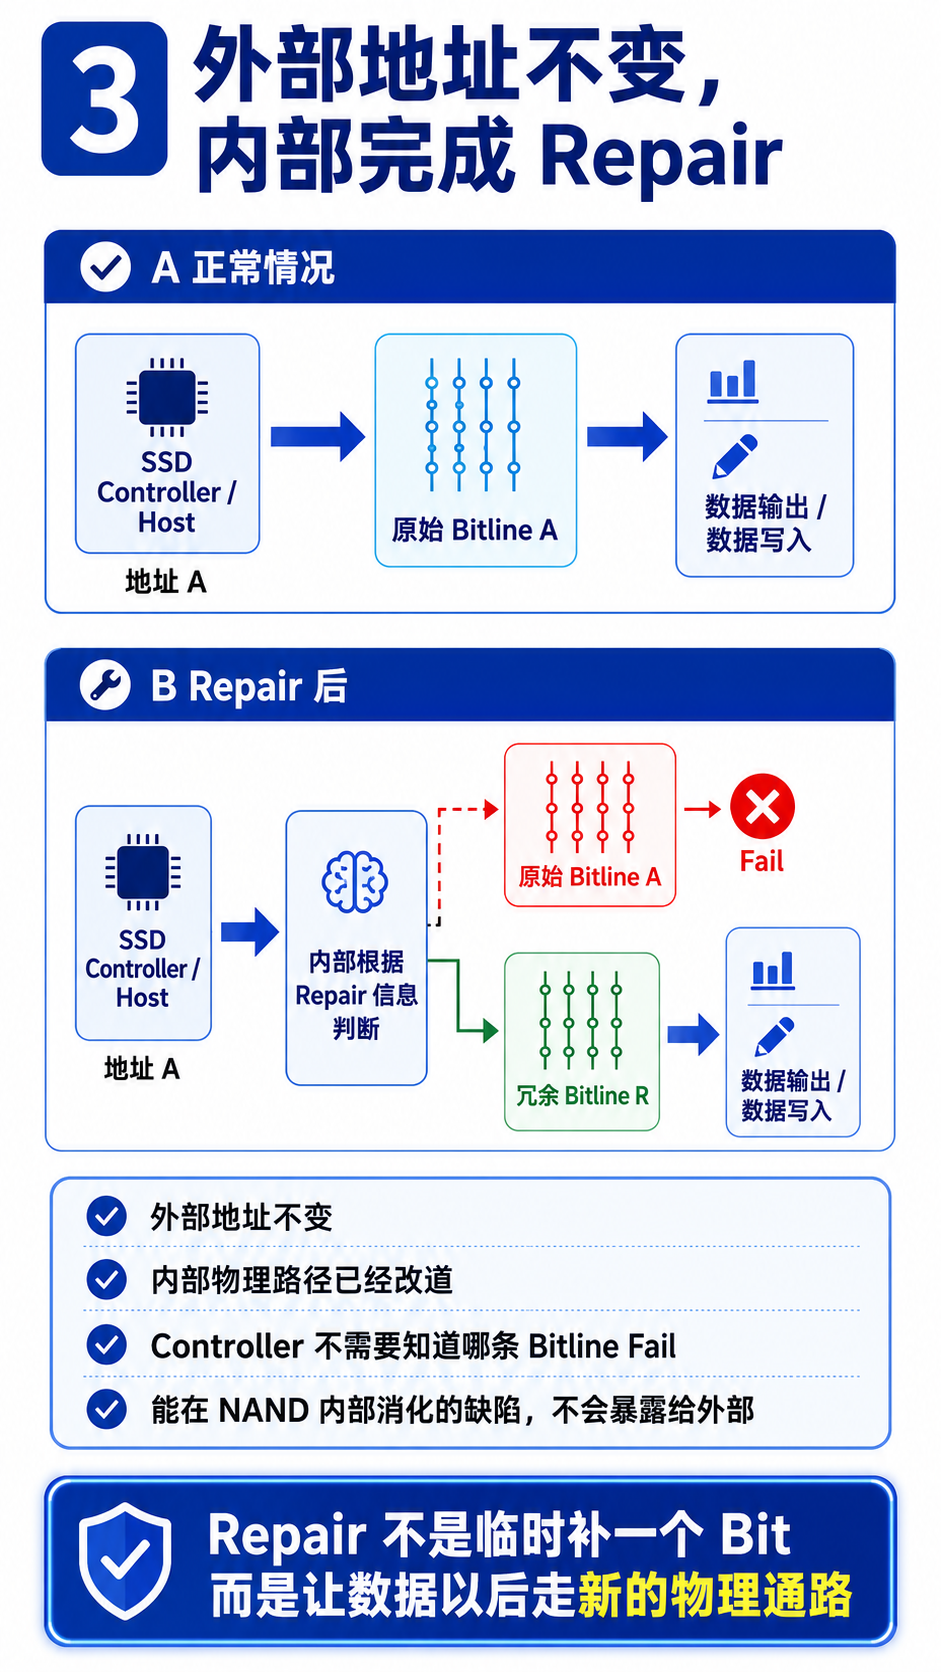
假设 CP 测试已经发现原始 Bitline A 存在缺陷,并为它分配了一条冗余 Bitline R。
从外部看,SSD Controller 访问的地址并没有发生变化。
NAND 又是怎样把数据转到冗余资源上的?
可以用一个简化模型来理解。
Repair 完成以后,NAND 会记录:
原始 Bitline A 已经 Fail,后续由冗余 Bitline R 接替。
Read 时,NAND 完成阵列读取后,数据会进入 Page Buffer。
内部逻辑会根据当前访问地址和 Repair 信息,判断这次读取的数据是否涉及已经失效的物理通路。
如果没有命中 Fail 位置,数据按照正常路径输出。
如果命中,NAND 会从冗余 Bitline 中取出对应的数据,再把它放回原本应该出现的位置。
例如,原来准备输出:
D0、D1、D2、D3、D4、D5、D6、D7
其中 D3 对应的原始物理通路已经失效。
Repair 生效以后,最终输出的可能是:
D0、D1、D2、R0、D4、D5、D6、D7
其中 R0 来自冗余资源。
外部 Controller 收到的仍然是一组完整数据,不会知道其中某一位已经被内部替换。
Program 时也是一样。
外部送进来的数据仍然按照原来的地址排列,但如果某一部分数据原本对应 Fail 资源,NAND 不会再把它写到原来的物理位置,而是把它送往已经分配好的冗余资源。
所以,冗余 Repair 不是 Read 时发现数据不对,再临时补一个 Bit。
它实际上改变了数据在 NAND 内部真正经过的物理路径:
外部地址没有变化,内部数据通路已经改道。
对于 SSD Controller 来说,NAND 仍然提供相同的地址、相同的接口和相同的命令。
Controller 并不知道:
• 哪条 Bitline 曾经 Fail; • 哪部分数据已经转移到冗余资源; • NAND 内部完成过多少次 Repair。
这种对外透明的设计非常重要。
如果每一个内部制造缺陷都要交给 SSD Controller 管理,那么 Controller 不仅要知道 Block 和 Page,还要知道每颗 NAND 内部具体哪条 Bitline 出现了问题。
这样接口会变得非常复杂。
所以,能够在 NAND 内部完成 Repair 的制造缺陷,通常不会再暴露给外部。
为什么最后仍然会留下初始坏块?
Repair 完成以后,NAND 还必须永久记住:
• 哪些位置存在 Fail; • 哪些冗余资源已经被使用; • 原始资源和冗余资源之间是什么对应关系。
这些信息不能只放在普通寄存器中。
因为 CP 测试结束以后,晶圆还要掉电、切割、封装,最终才会被装进 SSD。
普通寄存器掉电后,信息就会消失。
因此,NAND 需要把 Repair 信息固化到不会轻易丢失的配置区域。
可以把它理解成 NAND 出厂前写下的一份永久档案。
这份档案告诉芯片:
哪些物理路径已经失效,以后访问时应该使用哪一份冗余资源。
NAND 初始化时会读取这些配置,之后每一次 Read 和 Program,都按照已经确定的 Repair 关系工作。
但即使有了冗余资源和 Repair 信息,NAND 出厂时仍然可能存在初始坏块。
原因很简单:
冗余能力是有限的,而且不是所有缺陷都适合 Repair。
例如:
• Fail 数量超过冗余资源数量; • 多个 Fail 集中在同一个区域; • Wordline 或其他结构出现严重故障; • Repair 完成后复测仍然失败; • 冗余资源本身也存在缺陷; • 某些关键外围电路无法正常工作。
遇到这些情况,NAND 就无法继续把缺陷隐藏在内部。
如果问题只影响某个 Block,而且外部可以绕开,那么该 Block 会被留下 Bad Block Marker,成为 Factory Bad Block。
如果问题影响整颗 Die 的关键功能,或者不可修复缺陷超过产品规格,那么整颗 Die 就会被判 Fail。
所以,初始坏块不是 NAND 完全没有做任何处理的结果。
恰恰相反:
它是 NAND 内部完成 CP 测试和冗余 Repair 以后,仍然无法被覆盖的剩余缺陷。
写在最后
我们通常会认为,一颗合格的 NAND,内部所有 Cell 和线路都应该从一开始就完全正常。
但实际情况并不是这样。
一颗 Die 被判定为合格,真正代表的是:
它最终提供给外部的存储空间和功能,能够满足产品规格。
在制造和 CP 测试过程中,Die 内部可能已经发现过一些局部 Fail。
其中:
• 能够通过冗余资源完成 Repair 的,会被隐藏在 NAND 内部; • 无法 Repair 但可以绕开的,会被留下初始坏块标记; • 超出产品规格的,才会导致整颗 Die 被淘汰。
所以,NAND 的可靠性并不意味着它从来没有出现过缺陷。
真正的可靠,是缺陷出现以后,还有下一层机制可以接住它。
而上一篇看到的 Factory Bad Block,正是 NAND 内部已经尝试过冗余 Repair 以后,最终仍然留给 SSD Controller 处理的部分。
一颗合格的 NAND Die,不一定从未出现过制造缺陷。
它只是已经知道哪些物理资源不能再用,并在可能的情况下,提前把数据通路切换到了冗余资源。
 Alipay
 Wechat