在前两篇文章中,我们已经讨论过两个问题:
NAND为什么允许带着坏块出厂,以及少量Cell出现问题以后,为什么不需要报废整颗Die。
但是,发现坏块只是第一步,对于SSD来说,后面还有一系列问题需要解决:
1. 这个坏块的地址应该记录在哪里?
2. 以后分配物理空间时,怎样保证不会再次选中它?
3. SSD重新上电以后,怎样记得它是坏的?
4. 坏块越来越多,又会对SSD产生什么影响?
这些工作,属于FTL中的坏块管理。
简单来说,FTL的坏块管理主要围绕四件事展开:
识别坏块、记录坏块、跳过坏块,以及用其他健康空间补充损失的物理资源。
一、坏块管理首先要知道:到底是哪一个Block坏了?
NAND中的坏块不是一个简单的数字。
FTL必须准确知道它位于哪一颗NAND、哪一个Die或者LUN、哪一个Plane,以及具体是哪一个Block。
例如,可以把一个坏块的物理位置抽象地表示为:
Die 2、Plane 1、Block 358。
只有记录了完整的物理地址,FTL才能确保后续的Program、Erase和Block分配不再访问这个位置。
坏块大致可以分成三类。
第一类是出厂时就已经存在的坏块。
这些Block在NAND生产测试阶段没有达到厂商要求,出厂时便会留下相应的坏块信息。SSD初始化NAND时,需要把这些Block识别出来。
第二类是使用过程中逐渐产生的坏块。
一个Block出厂时可能完全正常,但随着Program和Erase次数增加,内部存储单元逐渐老化,最终可能无法继续可靠地完成操作。
第三类是状态暂时无法确定的Block。
例如NAND正在Program或者Erase时突然掉电,这个Block不一定真的发生了永久性损坏,但它的状态已经不能完全信任。
对于这种Block,固件可能采用保守策略直接隔离,也可能先将它标记为可疑状态,经过进一步检查后再决定是否继续使用。
所以,实际FTL中的Block状态未必只有“正常”和“坏块”两种。
还可能存在一种中间状态:
目前还不能确定它真的坏了,但在确认之前不能继续使用。
二、FTL用什么记录坏块?
坏块被识别出来以后,FTL需要把它记录下来。
最常见的数据结构叫作BBT。BBT是Bad Block Table的缩写,也就是坏块表。
一种比较直观的实现方式,是使用Bad Block Bitmap。
假设一颗Die中有4096个Block,就可以为每个Block分配一个Bit:
0表示Block可以使用;
1表示Block已经被标记为坏块。
当Block 358被判定为坏块时,固件便把Bitmap中对应的Bit置为1。
这种方式占用空间很小,查询速度也很快。
不过,实际FTL中的Block状态往往更加复杂。
除了正常和坏块,还可能需要区分:
1.出厂坏块;
2.运行时新增坏块;
3.可疑Block;
4.保留Block;
5.正在使用的Block;
6.等待垃圾回收的Block。
因此,有些FTL并不会单独维护一张简单的坏块Bitmap,而是把坏块状态合并到更完整的Block管理表中。
无论具体采用哪种形式,它们解决的核心问题都是一样的:
告诉FTL,哪些物理Block不能再参与正常使用。
三、把坏块写进BBT,管理就完成了吗?
还没有。
FTL在需要新Block时,并不会每次都从第一颗NAND开始,把所有Block重新检查一遍。
为了提高效率,FTL通常会提前维护不同类型的物理资源队列,例如:
空闲Block池;
正在写入的Block列表;
垃圾回收候选列表;
磨损均衡候选列表;
各个Die或者Plane的可用Block统计。
假设某个Block已经在BBT中被标记为坏块,但它仍然残留在空闲Block池里,那么Block分配器以后仍然可能再次选中它。
因此,一个Block被标记为坏块以后,FTL不仅要修改BBT,还需要同步处理所有与它有关的资源管理信息。
例如:
从空闲Block池中移除;
停止将它作为新的写入Block;
不再把它当作擦除后可以重新利用的空间;
从垃圾回收和磨损均衡的候选列表中排除;
更新对应Die或者Plane的可用Block数量。
所以,坏块管理并不是简单地在一张表里写下:
这个Block坏了。
它真正要做的是:
把这个Block从整个FTL的物理资源管理体系中移除。
四、后续分配空间时,FTL怎样避开坏块?
Host向SSD写入数据时,只会提供LBA,并不会指定数据必须写入哪一个物理Block。
真正写到哪里,由FTL中的空间分配机制决定。
当FTL需要新的物理空间时,Block分配器会从可用Block中选择合适的位置。
选择时可能会考虑:
Block的P/E次数;
它位于哪一个Die和Plane;
是否有利于并行访问;
是否满足磨损均衡要求;
当前空闲空间是否充足。
而“这个Block是不是坏块”,是最基本的一道筛选条件。
一旦Block被标记为坏块,它就不能再被选作新的写入空间。
也不应该再次对它执行Erase,然后尝试让它重新进入空闲Block池。
这就是坏块跳过策略的核心:
坏块仍然物理存在于NAND中,但FTL以后不再把它当作可用资源。
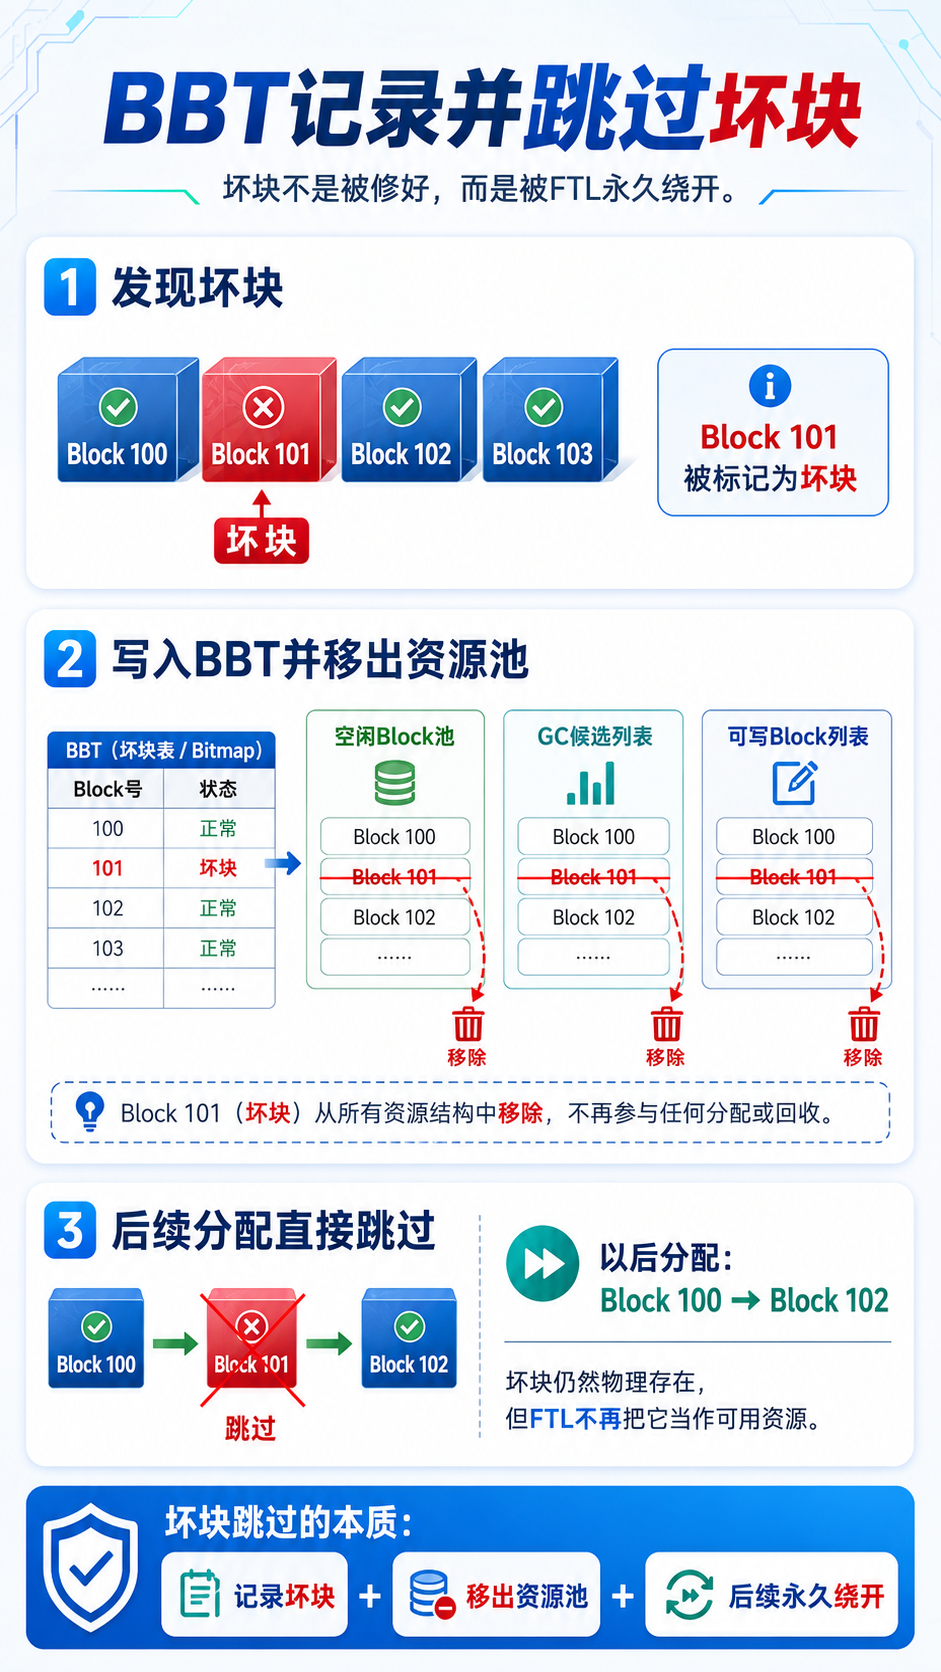
例如,Block 100、Block 101和Block 102中,Block 101已经被记录为坏块。
当FTL按照顺序寻找可用空间时,会直接从Block 100跳到Block 102。
Block 101不会被修复,也不会从芯片中消失,只是在FTL的物理空间管理中被永久绕开。
如图所示:
五、“跳过坏块”和“替换坏块”有什么区别?
坏块管理中经常会出现两个说法:
坏块跳过和坏块替换。
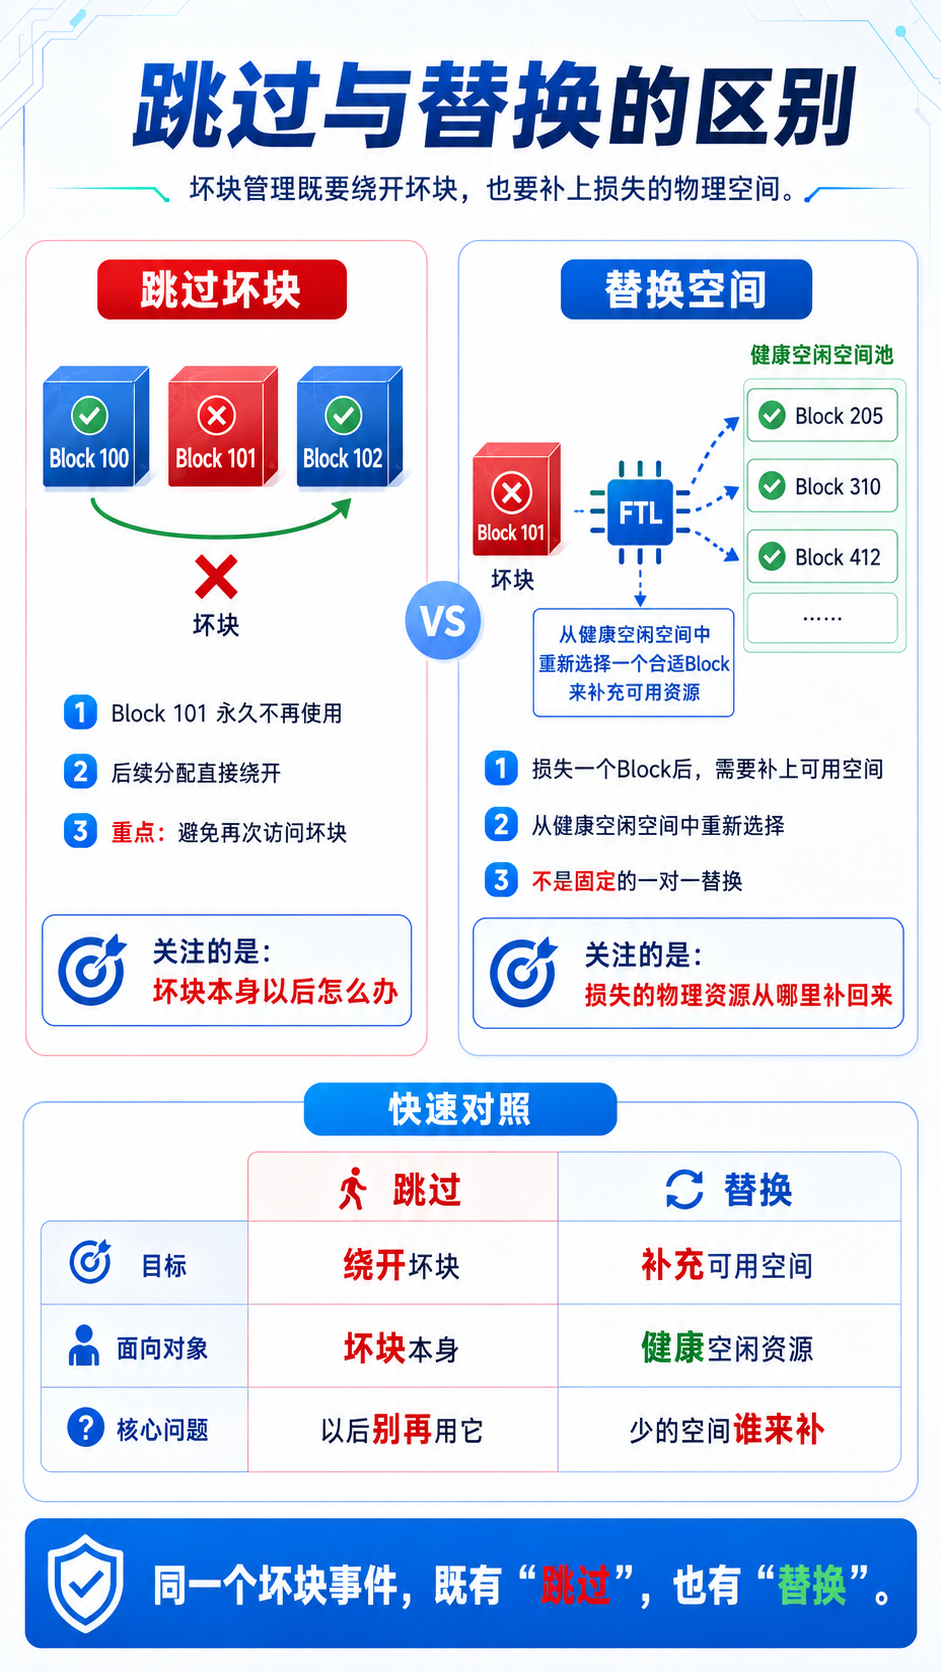
1.坏块跳过
坏块跳过关注的是:
以后不再访问这个Block。
对于出厂坏块,SSD初始化时就会记录下来,后续空间分配直接绕过。
对于使用过程中新增的坏块,在更新坏块状态以后,后续的Program、Erase和空间分配也不会再选择它。
2.坏块替换
坏块替换关注的是:
少了一个Block以后,原本需要的物理空间从哪里补回来?
一个Block被退役,意味着SSD内部健康的物理空间少了一块。
FTL需要继续从其他健康的空闲空间中分配Block,使SSD能够维持正常工作。
需要注意的是,这通常不是固定的一对一替换。
并不是Block 100损坏以后,系统就永久指定Block 101作为它的替身。
FTL只是从当前健康的空闲Block中,重新选择一个满足条件的位置。
如图所示:
因此,“跳过”和“替换”其实是在描述同一件事的两个方面:
对坏块本身,是永久跳过;
对损失的物理资源,是从其他健康空间中重新补充。
六、OP是不是专门用来替换坏块的?
说到坏块替换,经常会提到OP空间。
OP是Over Provision的缩写,可以理解为SSD内部没有直接开放给Host使用的物理空间。
一块对外标称容量为1TB的SSD,内部实际配置的NAND容量通常会比1TB更大一些。
多出来的空间由FTL统一管理。
当某个Block变成坏块以后,FTL仍然可以从剩余的健康空间中继续分配Block,因此Host看到的容量不会因为损坏一个Block就立即减少。
但不能把OP简单理解成一批专门等待替换坏块的固定备用Block。
OP还要承担很多其他任务,例如:
垃圾回收;
磨损均衡;
有效数据迁移;
维持持续写入性能;
为后台管理提供周转空间。
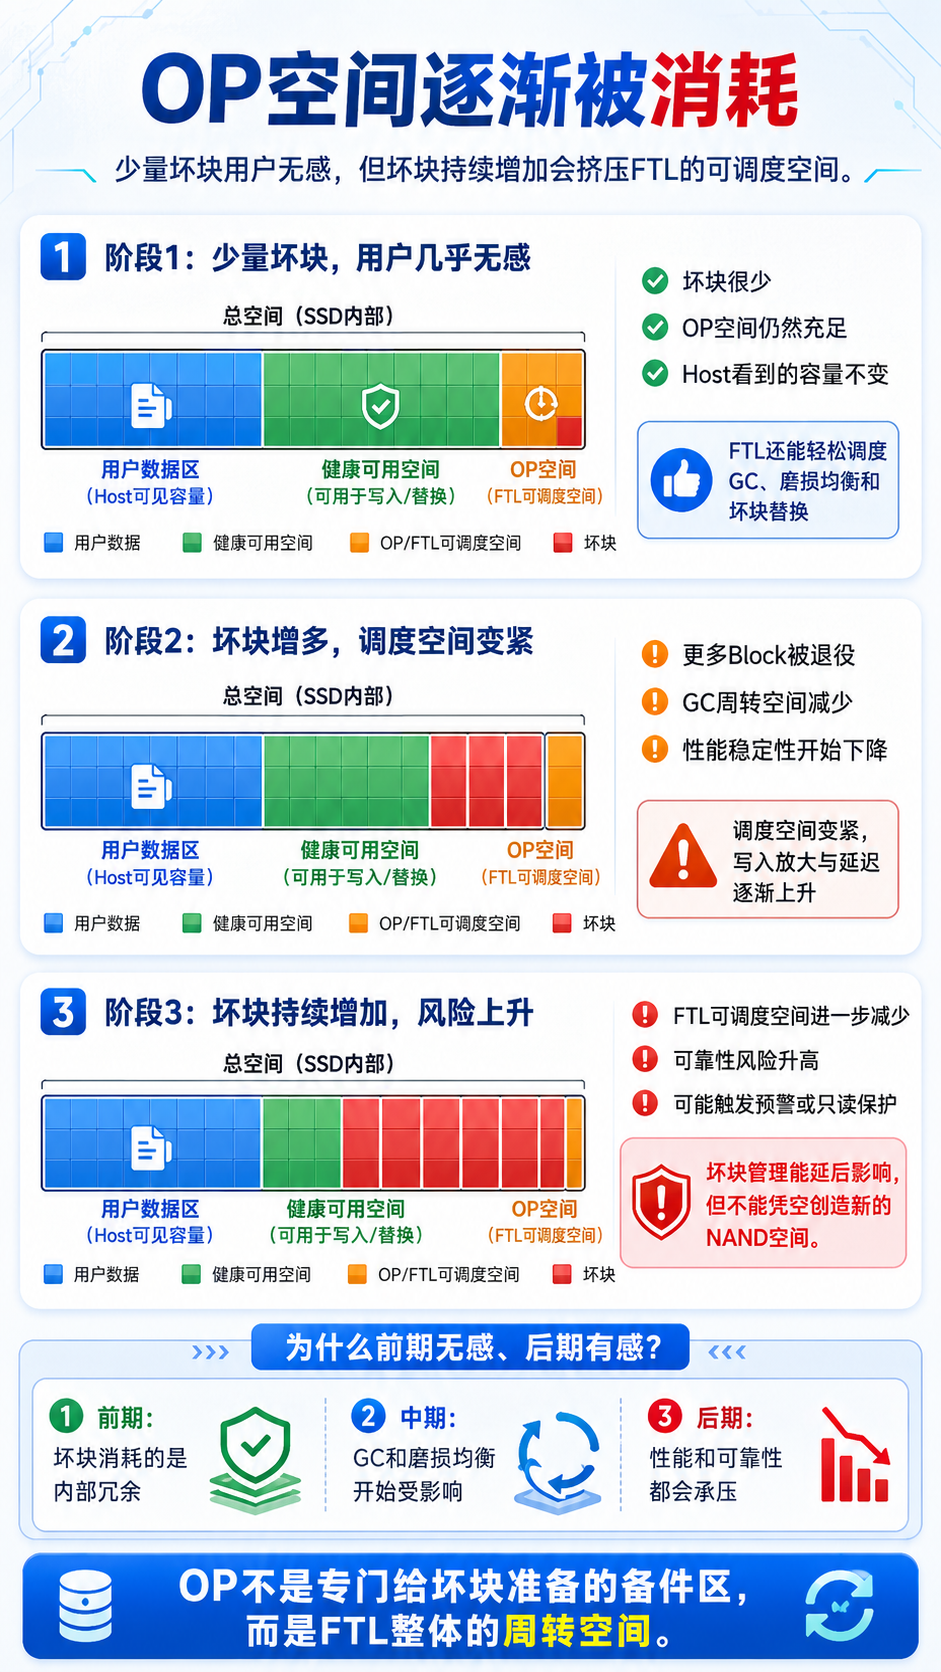
因此,坏块增加消耗的并不是某个独立的“坏块备件区”,而是SSD内部整体可调度的物理空间。
坏块越多,留给垃圾回收、磨损均衡和数据迁移的空间就越少。
如图所示:
七、BBT为什么不能只保存在RAM里?
SSD运行过程中,为了快速查询,坏块信息通常会被加载到RAM中。
但是,RAM中的数据在掉电后会消失。
如果坏块记录只存在于RAM中,那么SSD重新上电以后,就会忘记哪些Block已经损坏。
这些坏块甚至可能重新进入空闲Block池,再次被用于保存用户数据。
因此,坏块信息必须持久化保存在NAND中。
SSD重新上电以后,再把坏块信息读取出来,恢复到RAM中。
但这里又会产生一个新的问题:
保存BBT的NAND本身也可能发生错误。
如果BBT只有一份,而保存它的Page或者Block损坏,SSD就可能丢失坏块记录。
因此,实际设计中通常会对BBT进行保护,例如:
保存多个副本;
使用ECC保护;
增加CRC检查;
记录版本号或者序列号;
更新时保留新旧版本。
上电恢复时,FTL可以根据校验结果和版本信息,选择一份完整而且较新的坏块记录。
八、更新坏块信息时突然掉电怎么办?
假设FTL刚刚识别出一个新的坏块,并准备更新BBT。
如果BBT只修改了一部分就突然掉电,可能出现这样的情况:
RAM中已经知道这个Block是坏的;
但NAND中的BBT还没有完成更新。
下一次上电以后,如果FTL读取到的仍然是旧版本BBT,这个坏块就可能重新被当成正常Block。
因此,BBT更新本身也需要考虑掉电一致性。
一种比较容易理解的思路是:
1. 先写入新的BBT副本; 2. 确认新副本写入成功; 3. 再更新版本或者有效标记; 4. 最后再废弃旧副本。
这样即使在更新过程中突然掉电,上电以后仍然有机会找到至少一份完整记录。
具体实现方式会因SSD而不同,但基本目标是一致的:
坏块记录不能因为一次掉电而丢失,也不能因为更新中断而变得无法判断。
所以,BBT虽然看起来只是一张很小的表,却属于SSD非常重要的系统数据。
九、坏块越来越多以后,SSD会发生什么?
一个Block被标记为坏块以后,Host通常不会立即感受到变化。
因为FTL会跳过这个Block,并继续从其他健康空间中分配。
但是,SSD能够隐藏的坏块数量不是无限的。
随着坏块不断增加:
健康的物理Block逐渐减少;
空闲Block池变小;
垃圾回收的周转空间减少;
磨损均衡的选择范围缩小;
持续写入性能可能变得不稳定。
更重要的是,剩余的健康Block可能需要承担更多写入,从而进一步加快磨损。
当健康空间下降到一定程度以后,SSD可能开始上报可靠性风险。
如果剩余空间已经不足以安全地接收新数据,有些SSD还可能进入只读保护状态。
此时SSD可能仍然允许用户读取并备份已有数据,但不再接受新的写入。
因此,FTL坏块管理可以隔离坏块,却不能凭空创造新的NAND空间。
它只能利用原本保留的物理余量,把坏块对Host的影响尽可能延后。
十、FTL的坏块管理,到底管理了什么?
现在可以把整个过程概括为:
识别坏块及其物理位置;
记录坏块状态;
更新BBT或者Block管理表;
把坏块从所有可用资源队列中移除;
后续空间分配时永久跳过;
使用其他健康空间补充损失的物理资源;
将坏块信息持久化,并在上电后恢复。
所以,FTL的坏块管理并不是把损坏的Block修好。
坏块仍然存在于NAND里面。
只是FTL以后不再信任它,也不再把它交给用户数据使用。
对NAND来说,坏块一直都在那里;
对Host来说,它却像从来没有存在过。
这就是FTL坏块管理真正完成的事情。
谢谢你读我的文章
 Alipay
 Wechat