如果你买了一块内存条,商家告诉你:
“里面有一小部分存储单元是坏的,不过不影响使用。”
你大概很难接受。
但在 NAND Flash 的世界里,一颗芯片出厂时允许存在少量坏块,却是一件正常的事。
这听起来似乎有些矛盾:
既然已经有 Block 不能可靠使用,为什么这颗 NAND 还能被认定为合格产品,甚至被装进 SSD?
原因在于,NAND 从设计之初就没有要求每一个 Block 永远完美。它选择的是另一条路线:
允许少量局部缺陷存在,只要能够提前找出来,并保证以后永远不再使用它们,整颗 NAND 就仍然可以可靠工作。
一、一颗 NAND 里面,到底有多少存储单元?
在前面的文章中,我们介绍过 NAND 的基本结构。
大量 Cell 组成 Page,大量 Page 再组成 Block,许多 Block 最终构成一颗 NAND。
Page 是读取和 Program 的基本单位,Block 则是擦除的基本单位。
一颗现代 NAND 内部包含的 Cell 数量极其庞大。随着容量不断提升,制造时需要在一块很小的硅片上,形成越来越多的晶体管、绝缘层、字线、位线和垂直通道。
这些结构不仅数量多,而且尺寸极小。
制造过程中只要出现微小的颗粒污染、材料缺陷、尺寸偏差,或者局部线路异常,就可能使某些 Cell 无法可靠工作。
例如:
- 某些 Cell 无法正常 Program;
- 某些 Cell 无法恢复到擦除状态;
- 相邻字线之间发生短路;
- 某一区域的漏电或可靠性达不到要求。
如果只要出现一个异常 Cell,就把整颗 NAND 全部报废,那么随着 NAND 容量越来越大,能够做到“整颗芯片一个缺陷都没有”的比例就会越来越低。
这会直接降低生产良率,并大幅推高 NAND 的成本。
二、有缺陷,不代表一定要把整个 Block 扔掉
NAND 厂商在生产过程中会进行大量测试。
发现缺陷以后,首先不一定直接把它判为坏块。
芯片内部通常会预留一部分冗余资源。例如,某一列 Cell 存在问题时,可以尝试使用备用列进行替代。
这有点像一条公路有一条车道损坏了,如果旁边还有备用车道,就可以重新调整线路,继续让整段道路工作。
但是,冗余资源并不是无限的。
如果缺陷范围太大,超过了备用资源的修复能力,或者出现了相邻字线短路等无法通过简单替换解决的问题,那么这个 Block 就无法再保证可靠性。
此时,厂商不会因为一个 Block 有问题,就把整颗 NAND 报废。
更常见的做法是:
将这个 Block 标记为坏块,同时继续使用芯片中其他正常的 Block。
这就是 Factory Bad Block,也叫 Initial Bad Block、Original Bad Block,即出厂坏块或初始坏块。
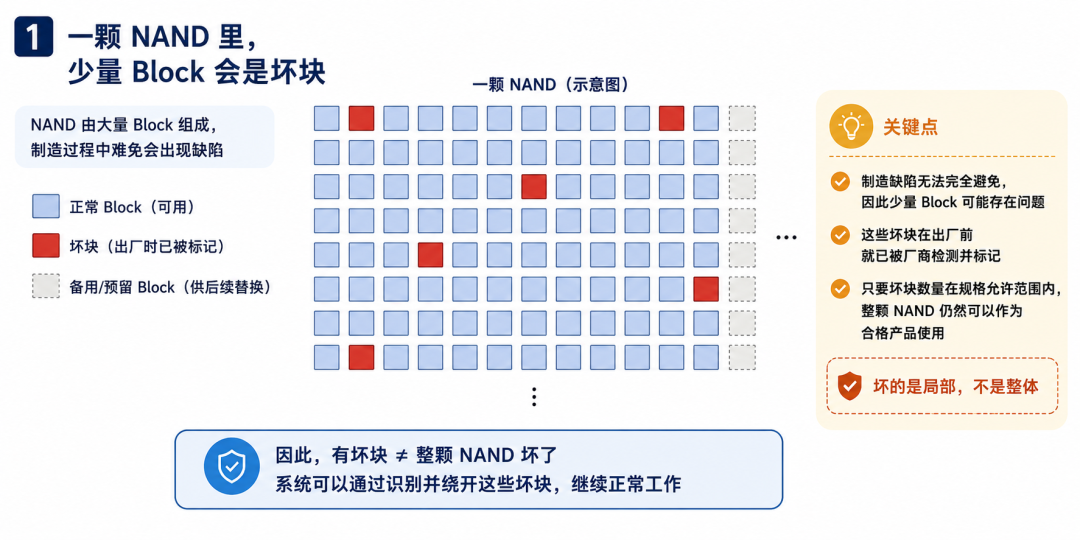
需要注意的是,“NAND 出厂时就有坏块”并不意味着每一颗 NAND 都一定有坏块。
更准确的说法是:
NAND 的产品规格允许存在一定数量的初始坏块。只要数量没有超过厂商承诺的上限,这颗 NAND 仍然属于合格产品。
三、厂商怎样告诉 SSD:“这个 Block 不能用”?
厂商测试出坏块以后,必须留下一种永久标志。
否则,SSD Controller 第一次拿到这颗 NAND 时,并不知道哪些 Block 正常,哪些 Block 已经被厂商判坏。
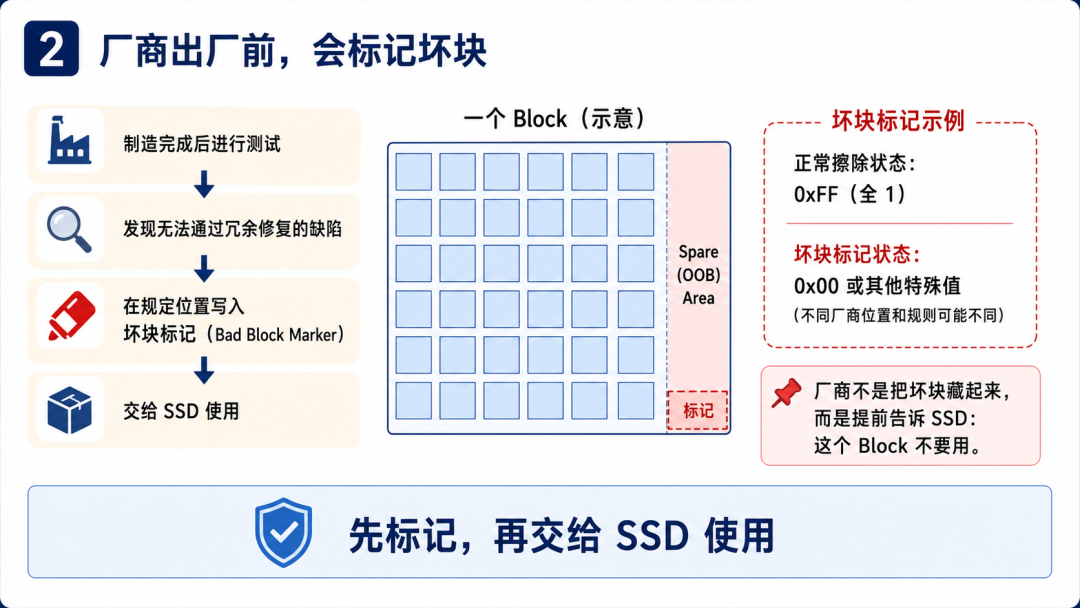
这个标志通常被称为 Bad Block Marker,也就是坏块标记。
NAND 厂商会在坏块中规定的 Page、Spare Area 或状态字节里写入一个特殊值。
正常擦除后的 NAND,数据通常表现为全 1,对应字节常写作 FF。
如果 Controller 在规定位置读到的不是 FF,而是厂商定义的特殊值,就说明这个 Block 已经被标记为坏块。
不过,这里不能简单理解为:
所有 NAND 都在第一页第一个 Byte 写 00。
不同厂商、不同型号以及不同代际 NAND,坏块标记的位置和规则可能不同。Controller 必须按照对应 NAND 的公开规格读取,不能自己猜测。
真正需要记住的只有一点:
厂商不是把坏块藏起来,而是在出厂前主动留下标记,告诉后续系统不要使用它。
四、SSD 第一次使用 NAND 时会做什么?
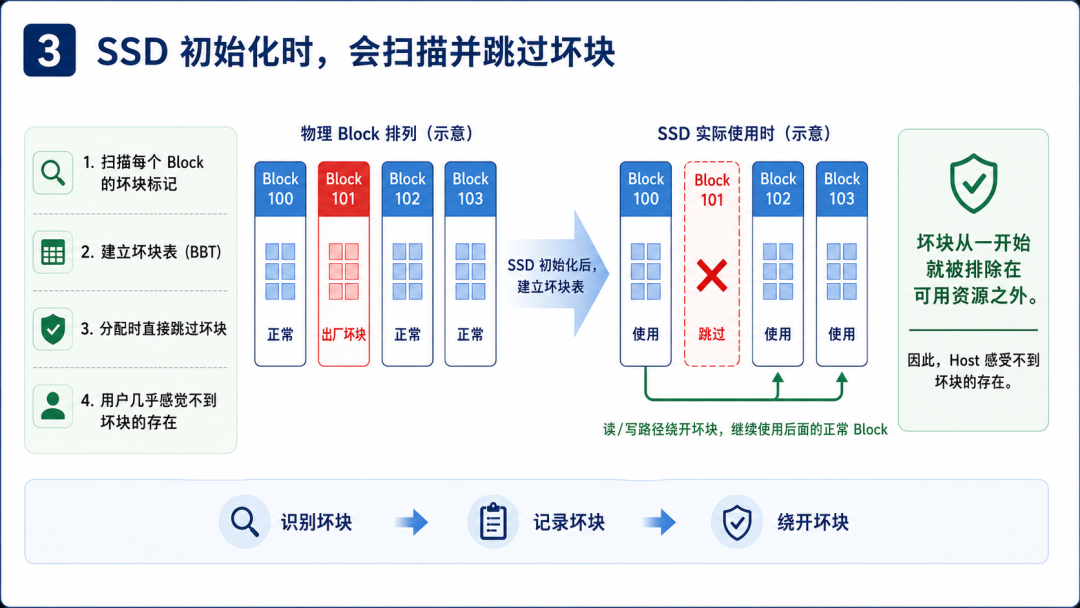
SSD 第一次初始化这些 NAND 时,会检查厂商留下的坏块标记。
它可以把整个过程理解为一次“道路普查”:
- 检查每个 Block 的规定位置;
- 判断是否存在 Bad Block Marker;
- 记录坏块的物理地址;
- 建立一张坏块表;
- 将这些 Block 排除在可用资源之外。
假设一颗 NAND 中有以下几个 Block:
Block 100:正常
Block 101:出厂坏块
Block 102:正常
Block 103:正常
那么 SSD 建立资源池时,就不会把 Block 101 当成可以存放数据的空间。
后续分配 Block 时,会从 Block 100 直接跳到 Block 102。
因此,所谓“跳过坏块”,并不是等数据写到 Block 101 以后才发现写不进去,再临时想办法。
而是从 SSD 正式工作之前,这个 Block 就已经被排除在外。
它不会成为:
- 用户数据 Block;
- 映射表 Block;
- GC 目标 Block;
- Firmware Metadata Block;
- 可以被再次分配的空闲 Block。
对于 SSD 来说,这个 Block 就像从来没有存在过一样。
五、少了几个 Block,为什么 SSD 容量没有变?
因为用户看到的容量,本来就不是 NAND 中所有物理 Cell 的简单总和。
SSD 内部通常还需要预留一部分额外空间,用于:
- Garbage Collection;
- Wear Leveling;
- Metadata;
- RAID 或其他冗余;
- 使用过程中产生的新坏块。
NAND 厂商也会对允许的初始坏块数量作出限制。
SSD 在设计容量时,已经把这些因素考虑进去。
假设一颗 NAND 物理上拥有 1000 个 Block,其中有少量 Block 在出厂时就被标记为坏块。
SSD 并不会先把 1000 个 Block 全部承诺给用户,再告诉用户容量缩水了。
它对外提供的逻辑容量本来就会小于内部的全部物理容量。只要坏块数量仍处于设计允许范围内,Host 看到的容量就不会受到影响。
这也是为什么你买到一块 SSD 后,不会在系统中看到:“这块盘因为有三个 NAND 坏块,所以少了几十兆容量。”
这些物理细节早已被 Controller 和 Firmware 隐藏起来。
六、出厂坏块与用坏的 Block 不是一回事
这一篇讨论的主要是出厂坏块。
它们在 NAND 生产测试阶段就已被发现,并由厂商提前留下标记。
但 NAND 在使用过程中,还可能出现另一类坏块。
一个 Block 出厂时完全正常,但经过多次 Program 和 Erase 后,绝缘层逐渐磨损,错误率越来越高,最终无法再可靠使用。
这种 Block 通常叫作 Grown Bad Block 或 Runtime Bad Block,也就是运行时坏块。
二者的区别是:
出厂坏块是在进入 SSD 之前就已存在;
运行时坏块则是在 SSD 使用过程中逐渐产生。
初始坏块只需要在第一次使用 NAND 时识别并避开,相对容易处理。
运行时坏块却可能已经存放了用户数据。Firmware 不仅要识别它,还要考虑怎样恢复数据、怎样搬到新位置,以及怎样保证以后不再使用它。
七、总结
NAND 允许存在少量出厂坏块,并不是厂商降低了质量标准,而是在制造成本、芯片良率和系统可靠性之间作出的工程选择。
一颗 NAND 内部拥有数量极其庞大的 Cell。要求所有 Cell、所有 Page、所有 Block 在制造后都绝对完美,会让大量本来可以正常使用的芯片被整体报废。
更合理的办法是:
能用冗余资源修复的缺陷先修复;
无法修复的局部区域标成坏块;
后续由 Controller 永久绕开。
因此,SSD 的可靠性从来不是建立在“NAND 中一个坏块都没有”之上。
它真正依赖的是:
坏块必须能够被准确找出来、明确标出来,并保证从此不再被使用。
NAND 负责告诉 Controller:
“这里不能存数据。”
而 SSD Firmware 要做的,则是让 Host 永远感觉不到这个 Block 曾经存在。
 Alipay
 Wechat