上一篇我们讲了 Read Retry。
Read Retry 做的事情,本质上是:
默认 read level 读不出来,那就换一组 read level 再试。
因为 NAND 里的数据,不是一个干净的 0 或 1,而是一堆 cell 的阈值电压分布。
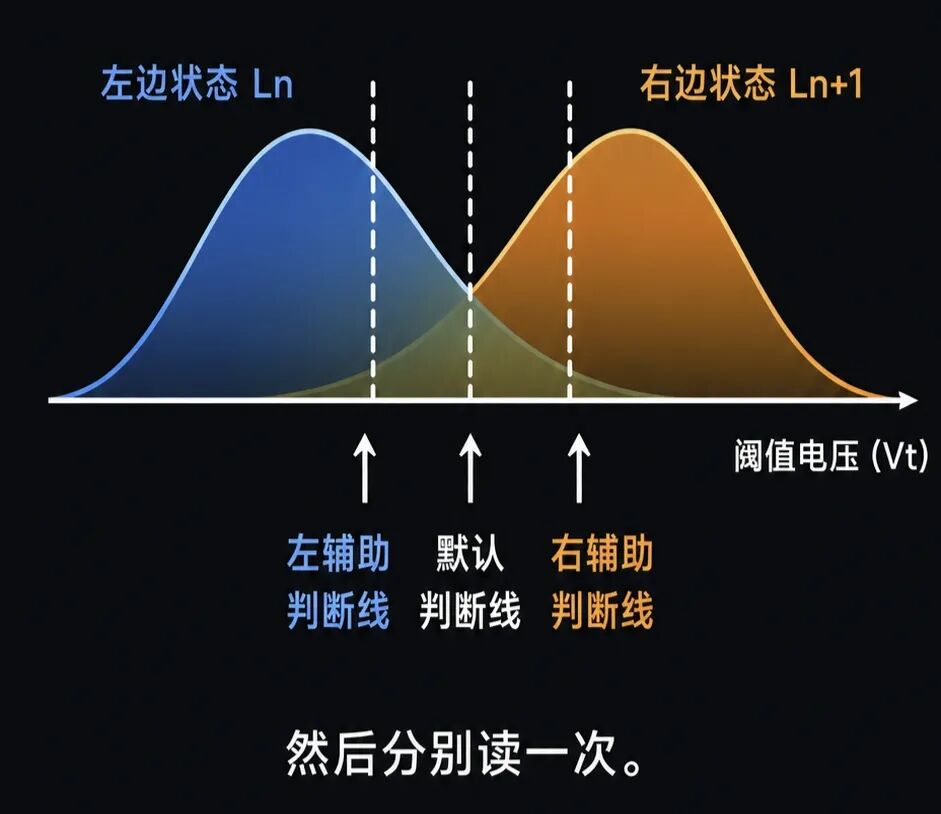
SSD 读取数据时,要在两个相邻分布之间放一条判断线。
这条判断线放得合适,读出来的错误 bit 就少。
这条判断线放偏了,原本属于左边状态的 cell,可能被判到右边;原本属于右边状态的 cell,也可能被判到左边。
所以 Read Retry 的逻辑很直观:
这条线不行? 那我换一条线。 还不行? 那我再换一条线。
它像是在一片模糊的电压分布里不断调整尺子,试图找到一个更合适的切分位置。
但这里还有一个更麻烦的问题:
如果不是判断线放错了,而是两个状态本身已经挤在一起了呢?
换句话说,Read Retry 可以解决一部分“线放得不够准”的问题。
但它不一定能解决“两个分布已经严重重叠”的问题。
当 Read Retry 仍然不够时,SSD 需要的就不只是“再换一条判断线”。
它还需要知道:
这一串读出来的 0 和 1 里面,哪些 bit 最可疑?
这时候,Soft Read 就该登场了。
一、Read Retry 的极限:换线也救不了所有 bit
我们可以把两个相邻状态想象成两座山。
理想情况下,它们中间有一个明显的山谷。
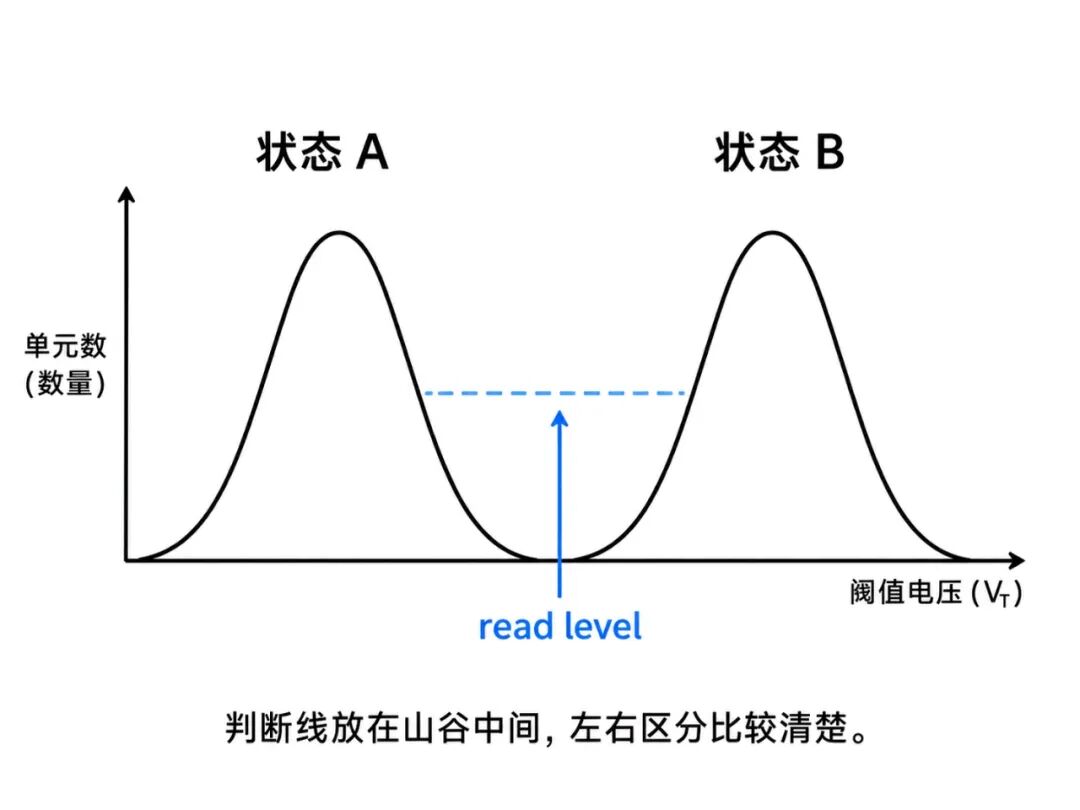
判断线放在山谷中间,左右区分比较清楚。 这个时候,默认 read level 就能比较稳定地把两个状态分开。
但 NAND 用久之后,情况会变差。
P/E 次数增加、数据放置时间变长、温度变化、read disturb 累积,都会让这些分布变宽、漂移,甚至互相重叠。
最后可能变成这样:
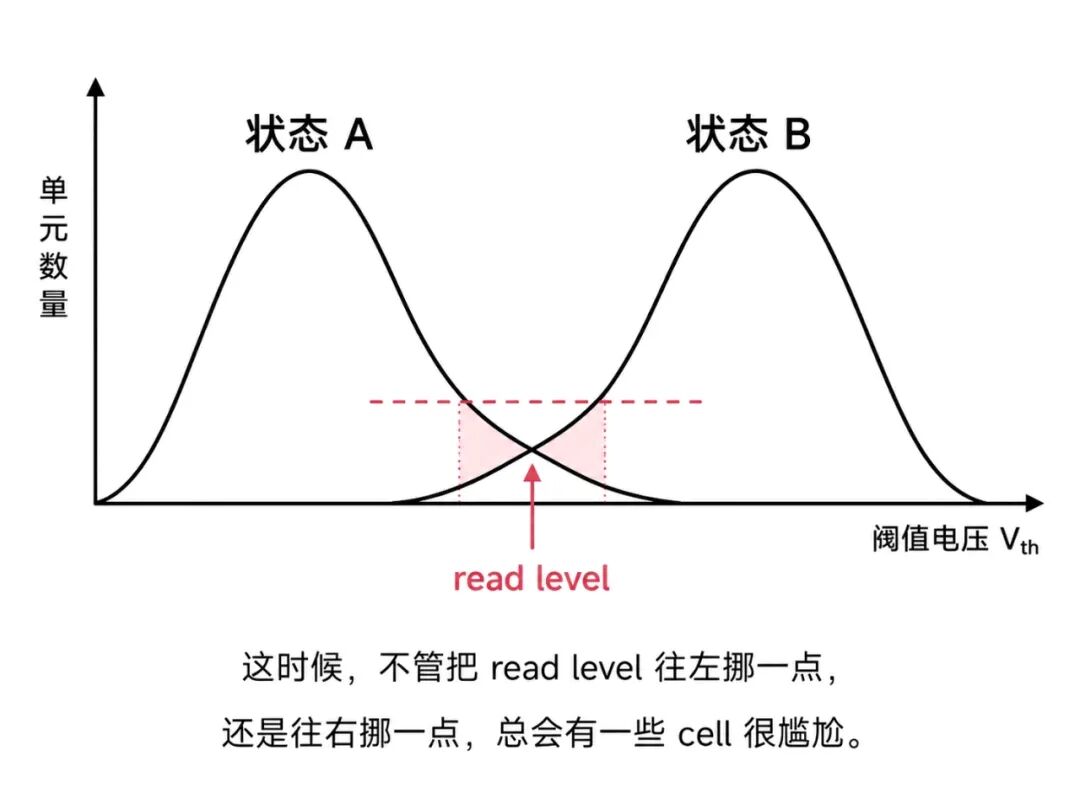
这时候,不管你把 read level 往左挪一点,还是往右挪一点,总会有一些 cell 很尴尬。
它们刚好贴在判断线附近。
对于这些 cell 来说,问题已经不是:
判断线有没有放在最优位置?
而是:
它们本身就太靠近边界了。
这种 bit 最危险。
因为它们今天可能被判成 1,明天可能被判成 0。
温度变一下,可能翻。
再被读几次,可能翻。
数据多放一段时间,也可能翻。
Read Retry 能做的是换线。
但如果某些 bit 本来就在边界附近,换线只能改变它们这一次被判到哪边,却不能告诉 ECC:
哪些 bit 是最不可靠的。
而这,正是 Soft Read 要解决的问题。
二、Hard Read 的问题:只告诉结果,不告诉信心
普通读取,也就是 Hard Read,只会告诉 SSD:
这个 bit 是 1。 这个 bit 是 0。
它不会告诉 SSD:
这个 1 是非常确定的 1? 还是擦边猜出来的 1?
也不会告诉 SSD:
这个 0 是非常确定的 0? 还是勉强判出来的 0?
但是对 ECC 来说,这两种情况完全不一样。
一个离判断线很远的 1,是强 1。
一个贴着判断线的 1,是弱 1。
一个离判断线很远的 0,是强 0。
一个贴着判断线的 0,是弱 0。
问题是:
Hard Read 自己看不出这些区别。
它只会输出一串最终判断,比如 111000。
光看这串结果,SSD 只知道:
前三个 bit 被判成了 1,后三个 bit 被判成了 0。
但问题是,这 6 个判断里面,哪些是稳的,哪些是擦边猜出来的?
光靠 Hard Read 是不知道的。
因为 Hard Read 只做了一件事:
用一条 read level 把 cell 分到左边或右边。
它没有告诉你:
这个 1 离判断线很远? 还是刚好贴着判断线?
也没有告诉你:
这个 0 离判断线很远? 还是刚好擦边落在右边?
所以,看到 111000 这串 hard data,我们不能直接判断哪些 bit 很稳,哪些 bit 很危险。
这时候,SSD 需要更多信息。
它需要再问一个问题:
如果我把判断线稍微往左、往右挪一下,这些 bit 的结果会不会变?
如果某个 bit 不管怎么微调 read level,读出来都一样,说明它比较稳。
如果某个 bit 只要 read level 稍微一动,结果就从 1 变成 0,或者从 0 变成 1,说明它就在边界附近。
这个 bit 就值得怀疑。
这就是 Soft Read 要补上的信息。
它不是重新读出另一份用户数据,而是给原来的 hard data 加上一层判断:
哪些 bit 比较可靠,哪些 bit 比较可疑。
三、先看一张 Soft Read 的原理图
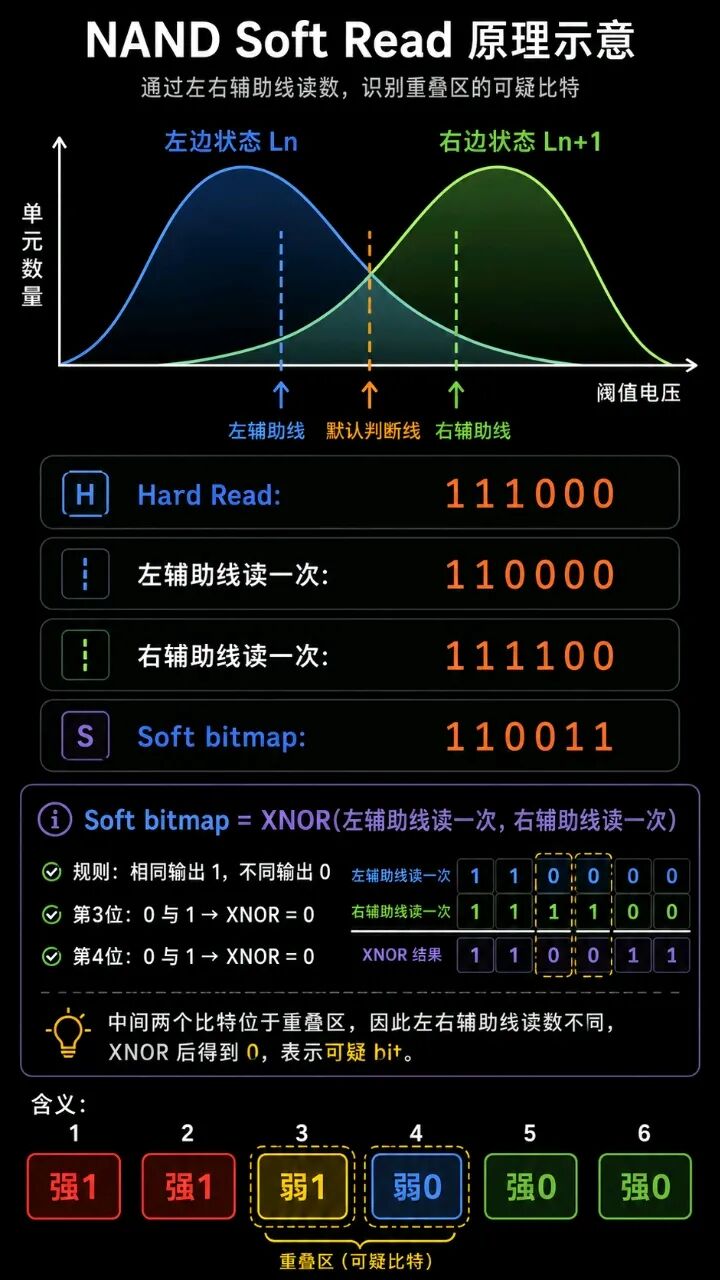
如图所示,当相邻状态的阈值电压分布开始重叠时,默认 read level 虽然仍能读出一串 Hard Read 结果,但它并不知道哪些 bit 是“稳的”,哪些 bit 是“擦边猜出来的”。
Soft Read 的做法,是在默认判断线两侧各再读一次。
一次用左辅助线。
一次用右辅助线。
然后把两次读取结果逐位做 XNOR:
相同输出 1。 不同输出 0。
这样一来,离边界较远的 bit 会被标记为可靠,而落在重叠区附近的 bit 会被标记为可疑。
图中间两个 bit,正是因为左右辅助读取结果不同,XNOR 后得到 0,所以它们分别对应“弱 1”和“弱 0”。
这也是 Soft Read 的核心价值:
它不是重新读出一份用户数据,而是告诉 ECC: 哪些 bit 最值得怀疑。
换句话说,Soft Read 要补充的不是“另一个答案”,而是“这个答案的可靠度”。
Hard Read 告诉你:
当前读出来是 0 还是 1。
Soft Read 进一步告诉你:
这个 0 或 1,到底稳不稳。
四、Soft Read 怎么把“可疑 bit”找出来?
这里继续结合配图看。
普通 Hard Read 得到的是 111000。
它的意思是:
NAND 这次判断,前三个 cell 更像 1,后三个 cell 更像 0。
但它还没告诉我们:
这几个 1 和 0,到底稳不稳?
Soft Read 的思路其实很朴素,于是 NAND 在默认判断线两侧各读一次。
既然我怀疑某些 cell 靠近判断线,那我就在默认判断线两边各放一条辅助判断线。
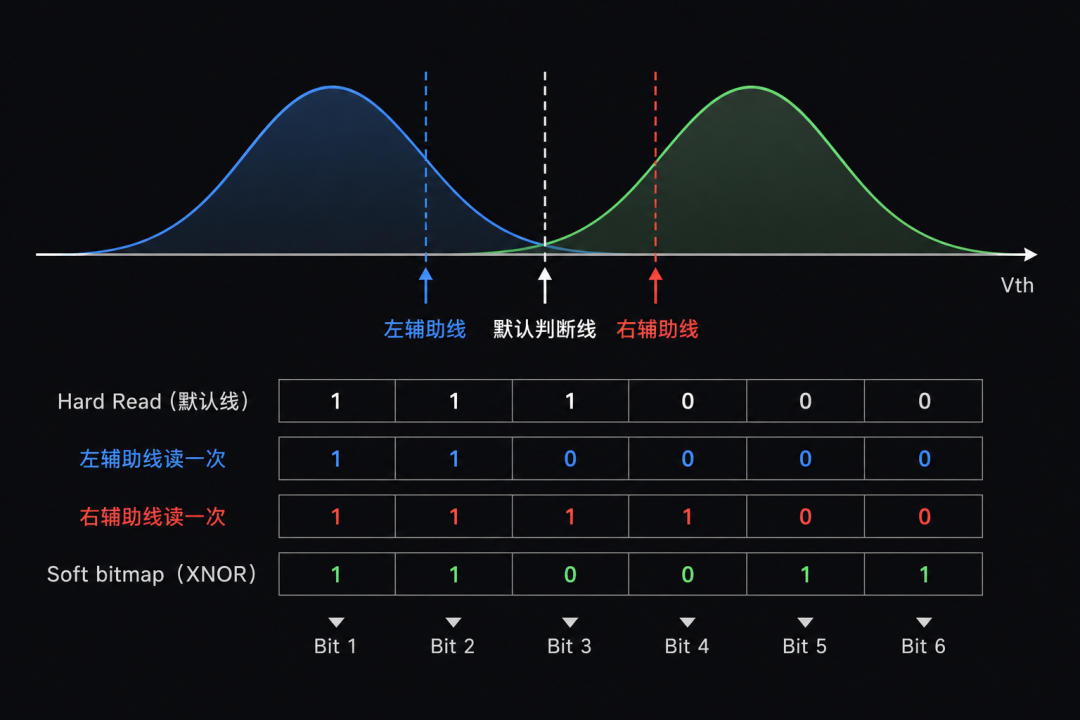
左辅助线读一次,得到 110000。
右辅助线读一次,得到 111100。
这两行数据不是最终返回给用户的数据。
它们只是用来判断可靠度。
判断方法很简单:
两次结果相同,说明稳定。 两次结果不同,说明可疑。
也就是逐位做 XNOR。
XNOR 的规则是:
相同输出 1。 不同输出 0。
所以:
左辅助线结果是 110000。
右辅助线结果是 111100。
XNOR 之后得到 110011。
这就是 Soft bitmap。
但这里一定要强调:
Soft bitmap 不是用户数据。
110011 不是说用户数据变成了 110011。
它表达的是可靠度。
1 表示这个位置比较可靠。
0 表示这个位置比较可疑。
所以:
Hard data 是 111000。
Soft bitmap 是 110011。
两者要放在一起看。
第 1 个 bit:Hard 是 1,Soft 是 1。所以它是强 1。
第 2 个 bit:Hard 是 1,Soft 是 1。所以它也是强 1。
第 3 个 bit:Hard 是 1,Soft 是 0。所以它是弱 1。
第 4 个 bit:Hard 是 0,Soft 是 0。所以它是弱 0。
第 5 个 bit:Hard 是 0,Soft 是 1。所以它是强 0。
第 6 个 bit:Hard 是 0,Soft 是 1。所以它也是强 0。
换成人话就是:
第 3 个和第 4 个 bit,最值得怀疑。
它们不一定错。但它们很危险。
因为只要判断线稍微挪一下,它们的结果就会发生变化。
五、Hard Decode 和 Soft Decode 有什么区别?
讲到这里,就必须区分两个概念:
Hard Decode。
Soft Decode。
很多人第一次看到这两个词,会以为它们是两种完全不同的 ECC。
其实更准确地说,它们的区别主要不是“用不用 ECC”,而是:
ECC 解码器拿到的信息有多少。
Hard Decode
普通 NAND read 之后,controller 拿到的是一串 hard data。
比如 111000。
这时候每个 bit 都已经被判死了。
是 1,就是 1。
是 0,就是 0。
ECC 解码器只知道:
这个位置读出来是 1。 那个位置读出来是 0。
但它不知道:
这个 1 是很稳的 1? 还是擦边判出来的 1?
也不知道:
这个 0 是很稳的 0? 还是勉强判出来的 0?
这就是 Hard Decode。
它的输入很简单:
只有 0 和 1。
它的特点也很明显:
1. 信息少。
2. 速度快。
3. 延迟低。
4. 正常读取优先使用。
所以在 SSD 的正常读路径里,一般都是先走 Hard Decode。
因为大多数时候,NAND 状态还没有差到需要动用更复杂的手段。
Soft Decode
Soft Decode 不一样。
它不满足于只知道:
这个 bit 是 1。 这个 bit 是 0。
它还希望知道:
这个 bit 是强 1,还是弱 1? 这个 bit 是强 0,还是弱 0?
也就是说,Soft Decode 需要 soft information。
刚才那个例子就能派上用场:
Hard data 是 111000。
Soft bitmap 是 110011。
合起来看,不是说用户数据是 110011。
而是说:
前两个 1 比较稳。 第三个 1 很可疑。 第四个 0 很可疑。 后两个 0 比较稳。
这样一来,ECC 解码器就不再是盲目地看一串 0 和 1。
它可以更有针对性地怀疑:
强 1,先相信。
强 0,先相信。
弱 1,重点怀疑。
弱 0,重点怀疑。
这就是 Soft Decode 的价值。
它不是更玄学地猜答案,而是利用 NAND 额外提供的可靠度信息,让纠错过程更有方向。
六、为什么 LDPC 很需要这些“可疑名单”?
前面讲 ECC 的时候,我们说过:
SSD 从 NAND 里读出来的数据,往往不是天然正确的。
它需要 ECC 来救。
但 ECC 也不是神仙。
如果只给 ECC 一串 hard data,ECC 只能知道:
这串数据和校验信息对不上。
但是它并不知道:
哪些 bit 更可能错了。
这就像老师批卷子。
只知道这张卷子总分不对,但不知道学生哪几道题最可能算错。
Soft Read 给 ECC 的帮助就在这里。
它会告诉 ECC:
这些 bit 很稳,先别怀疑它们。 这些 bit 靠近判断线,优先怀疑它们。
这对 LDPC 这类软判决 ECC 尤其重要。
因为 LDPC 不只是需要 0 和 1,它更希望知道每个 bit 的可靠度。
有了可靠度以后,解码器就可以更聪明地工作。
它会更愿意怀疑弱 bit,而不是随便去翻那些强 bit。
这就是为什么 Soft Read 能提高纠错能力。
它不是凭空创造信息。
它只是把 NAND 模拟世界里原本存在的“距离感”挖出来,变成 ECC 能利用的信息。
七、Soft Read 和 Read Retry 到底有什么区别?
Soft Read 很容易和 Read Retry 混在一起。
因为它们看起来都在调整 read level。
但目的不一样。
Read Retry 的目标是:
默认判断线可能放错了,那我换一条判断线重新读。
它更像是在问:
这条线读不出来? 那我换一条线再试试。
所以 Read Retry 的重点是找更合适的 read level。
每换一组 read level,就重新得到一版 hard data,然后再送给 ECC。
而 Soft Read 的目标是:
我不是单纯要换一条线,而是要知道哪些 bit 靠近边界。
它更像是在问:
这些读出来的 0 和 1 里面,哪些是擦边猜出来的?
所以两者可以这样区分:
Read Retry 是换线,重新判 0 和 1。 Soft Read 是多线读取,标记哪些 bit 可疑。
更形象一点:
Read Retry 是换一把尺子重新量。 Soft Read 是告诉 ECC,哪些测量结果不太稳。
这两者不是互相替代的关系。
在真实 SSD 里,它们往往会配合使用。
八、为什么不直接一上来就 Soft Read?
既然 Soft Read 这么有用,那为什么 SSD 不每次读取都用?
答案也很简单:
它慢。
普通读取只需要一次主要判断。
Soft Read 需要在判断线附近多读几次。
多读一次,就多一次 NAND sensing。
多读几次,就会增加读延迟。
而且 soft information 读出来以后,controller 还要把它转换成 ECC 能理解的可靠度信息去做 soft decode。
所以 Soft Read 通常不会出现在最普通、最健康的读取路径里。
更常见的流程是:
普通 Read。 先做 Hard Decode。 成功,就直接返回数据。 失败,再尝试 Read Retry。 仍然困难,再使用 Soft Read。 最后交给 Soft Decode 继续解码。
所以,Hard Decode 是正常读路径里的主力。
Soft Decode 更像是错误恢复路径里的重武器。
平时不用它,是为了速度。
关键时候用它,是为了把数据救回来。
九、为什么越到 TLC、QLC,Soft Read 越重要?
SLC 只有两个状态。
一个状态表示 1,另一个状态表示 0。
两个分布之间距离相对大。
但 TLC 有 8 个状态。
QLC 有 16 个状态。
状态越多,每两个状态之间的间隔就越小。
可以粗略理解成:
SLC 是两个山头,中间距离大。 TLC 是八个山头,山头之间更挤。 QLC 是十六个山头,山头之间更挤。
山头越挤,判断线越难放。
判断线稍微偏一点,或者分布稍微漂一点,就可能把某些 cell 判错。
这时候,ECC 不仅需要知道:
这个 bit 是 0 还是 1。
它还需要知道:
这个 bit 离边界有多近。
而 Soft Read 提供的,正是这种“离边界远不远”的信息。
所以从 SLC 到 MLC、TLC、QLC,NAND 越来越不像一个干净的数字系统。
它越来越像一个需要统计判断、概率推断和纠错算法一起配合的模拟系统。
这也是为什么现代 SSD 不能只看 NAND。
更要看 controller、ECC、Read Retry、Vth Tracking、Soft Decode 这些能力。
十、从 Read Retry 到 Soft Read,再到 Vth Tracking
把前面几篇串起来看,SSD 读数据大概有几层能力。
第一层,是普通读取。
用默认 read level 读出 hard data。
第二层,是 Hard Decode。
用 ECC 尝试纠正 hard data 里的错误。
第三层,是 Read Retry。
默认 read level 不合适,就换几组 read level 再读。
第四层,是 Soft Read。
不仅要读出 0 和 1,还要知道每个 0 和 1 靠不靠谱。
第五层,是 Soft Decode。
利用 hard data 和 soft information,提高 ECC解码成功率。
再往上,就是 Vth Tracking。
长期追踪 NAND 阈值分布怎么漂移,尽量提前把 read level 放到更合适的位置。
所以它们之间的关系可以这样理解:
Vth Tracking 是提前找更合适的判断线。 Read Retry 是读失败后换判断线。 Soft Read 是告诉 ECC 哪些 bit 最可疑。 Hard Decode 只根据 hard data 解码。 Soft Decode 根据 hard data 和可靠度信息解码。 ECC根据这些信息把数据救回来。
这才是现代 SSD 读取数据的真实样子。
它不是简单地从 NAND 里“拿出数据”。
它更像是:
在一堆已经变宽、漂移、重叠的电压分布里,先判断,再试错,再标记可疑点,最后由 ECC 把数据救回来。
十一、结尾:SSD 读数据,越来越像破案
如果说普通读取是在问:
这个 bit 是 0 还是 1?
Read Retry 是在问:
换个角度看,它会不会更像正确答案?
那么 Soft Read 问的是:
哪些 bit 最可疑?
这就像破案。
有些证人证词很稳定,前后怎么问都一样。
有些证人证词一换问法就变了。
Soft Read 要找的,就是那些“一换问法就变”的 bit。
它们未必一定错。
但它们最值得怀疑。
而对 SSD 来说,只要知道哪些 bit 最值得怀疑,ECC 就有了更大的机会把数据救回来。
所以 Soft Read 的核心不是“读出更多数据”。
而是:
读出更多关于数据可靠性的信息。
这也是 NAND 越来越复杂以后,SSD 必须具备的能力:
不只是会读。还要知道,哪些读出来的结果,其实只是擦边猜出来的。
 Alipay
 Wechat