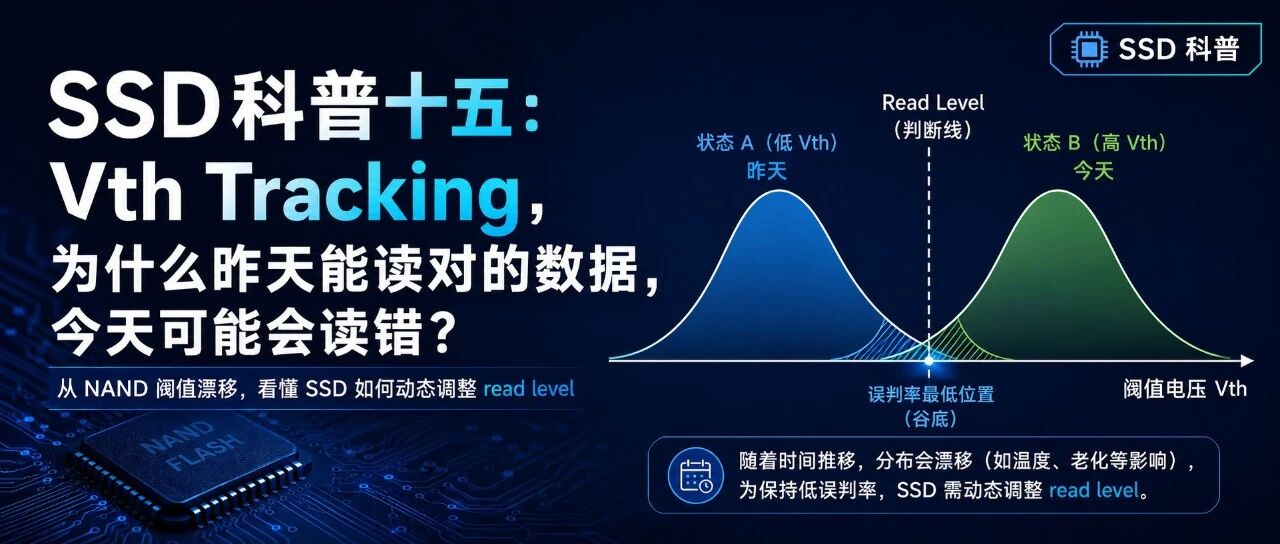
一、上一篇我们讲 Read Retry,这一篇要讲它背后的“追踪能力”
前面我们讲过,NAND 读取数据,本质上不是像硬盘那样把一个稳定的 0 或 1 直接拿出来。
NAND 读取更像是在问一个问题:
这个 cell 的阈值电压 Vth,到底落在哪个区间?
对于 TLC 来说,一个 cell 有 8 种状态。 对于 QLC 来说,一个 cell 有 16 种状态。
所以 SSD 读取 NAND 的时候,不是简单判断“有电 / 没电”,而是要用一组 read level,把这些状态分开。
可以把它想象成这样:
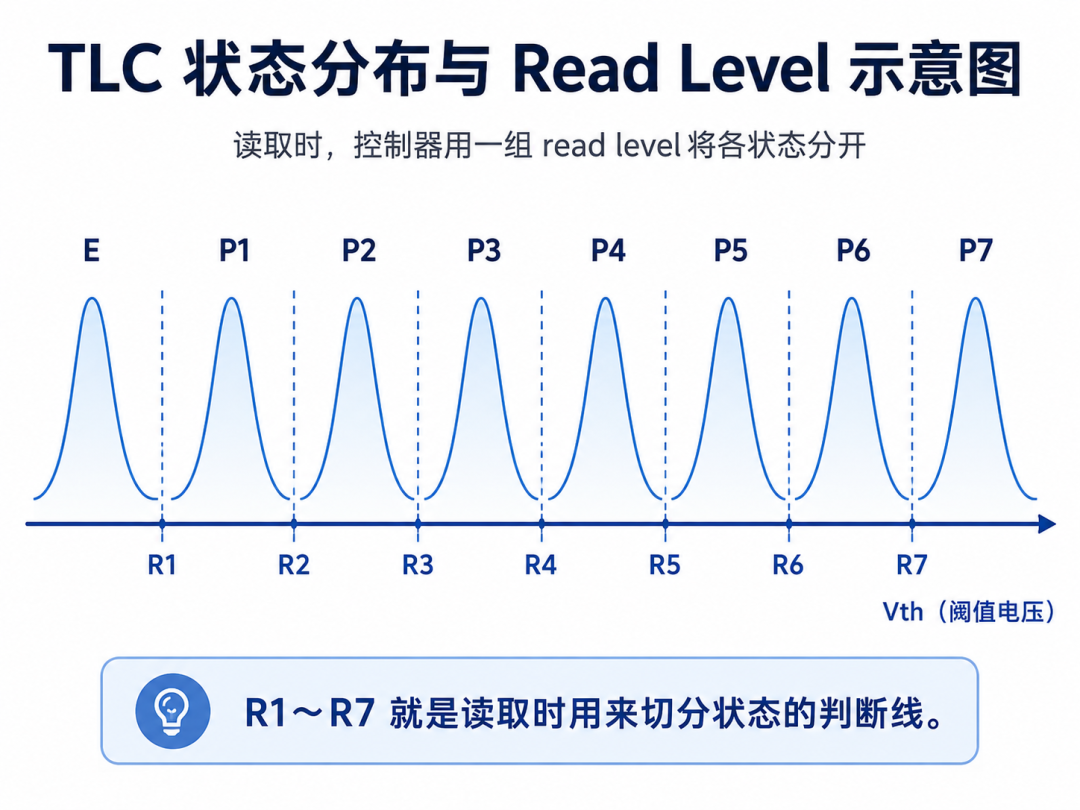
这些 R1、R2、R3……就是读取时用来切分状态的判断线。
问题是:
NAND 用久了以后,这些状态峰值不会一直待在原来的地方。
它们会移动,会变宽,会互相靠近。
于是原来好用的 read level,慢慢就不准了。
这时候,就需要 Vth Tracking。
二、什么是 Vth?
Vth,全称是 threshold voltage,阈值电压。
通俗说,就是:
让一个 cell 从“不导通”变成“导通”所需要的控制栅电压。
NAND 里面存数据,不是直接存 0 和 1,而是通过浮栅或者电荷捕获层里的电子数量,改变 cell 的阈值电压。
电子越多,Vth 越高。 电子越少,Vth 越低。
所以 NAND 里的数据,本质上是通过不同的 Vth 区间来表示的。
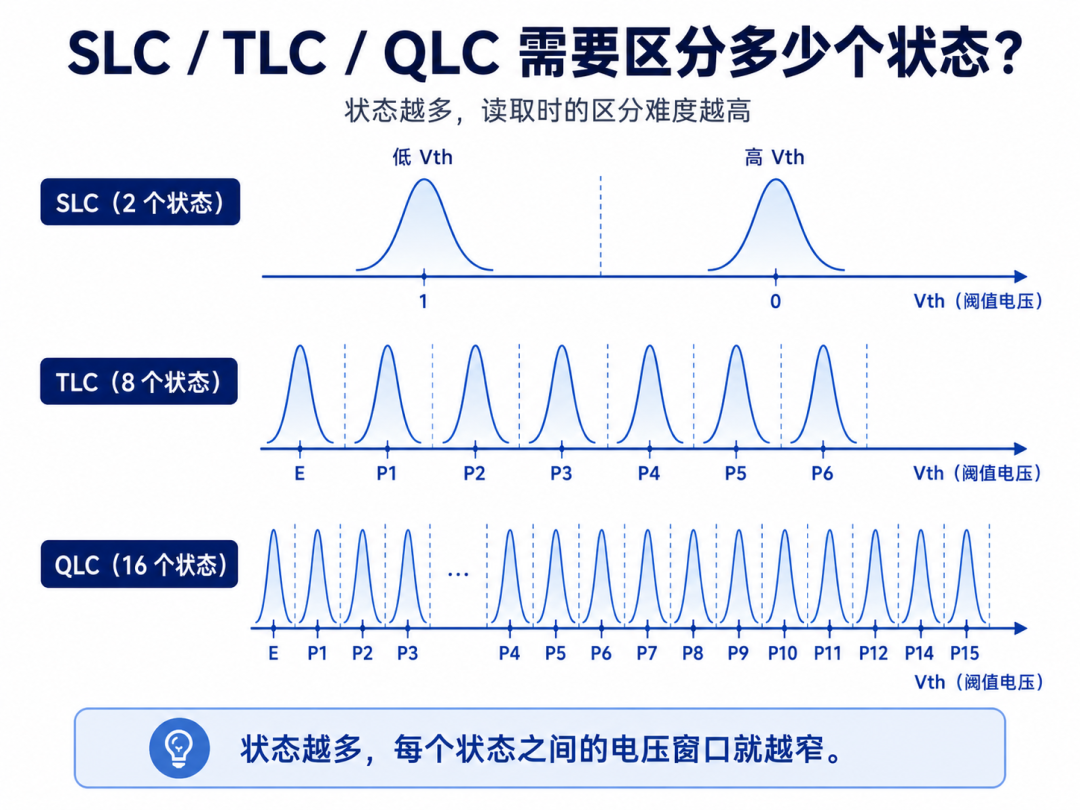
状态越多,每个状态之间的间隔就越小。
这也是为什么 QLC 比 TLC 更难读,更依赖 ECC、Read Retry、Vth Tracking 这些机制。
三、为什么 Vth 会变?
一个刚写完的数据,不代表它永远都保持原样。
NAND 不是一个完美的数字器件。 它更像一个会老化、会漂移、会受环境影响的模拟器件。
Vth 会因为很多原因发生变化。
比如:
P/E 次数增加数据放置时间变长温度变化读 disturb相邻 cell 干扰program 干扰电荷泄漏工艺差异
这些因素最后都会影响一个结果:
原来清楚分开的 Vth 分布,慢慢变得不那么清楚了。
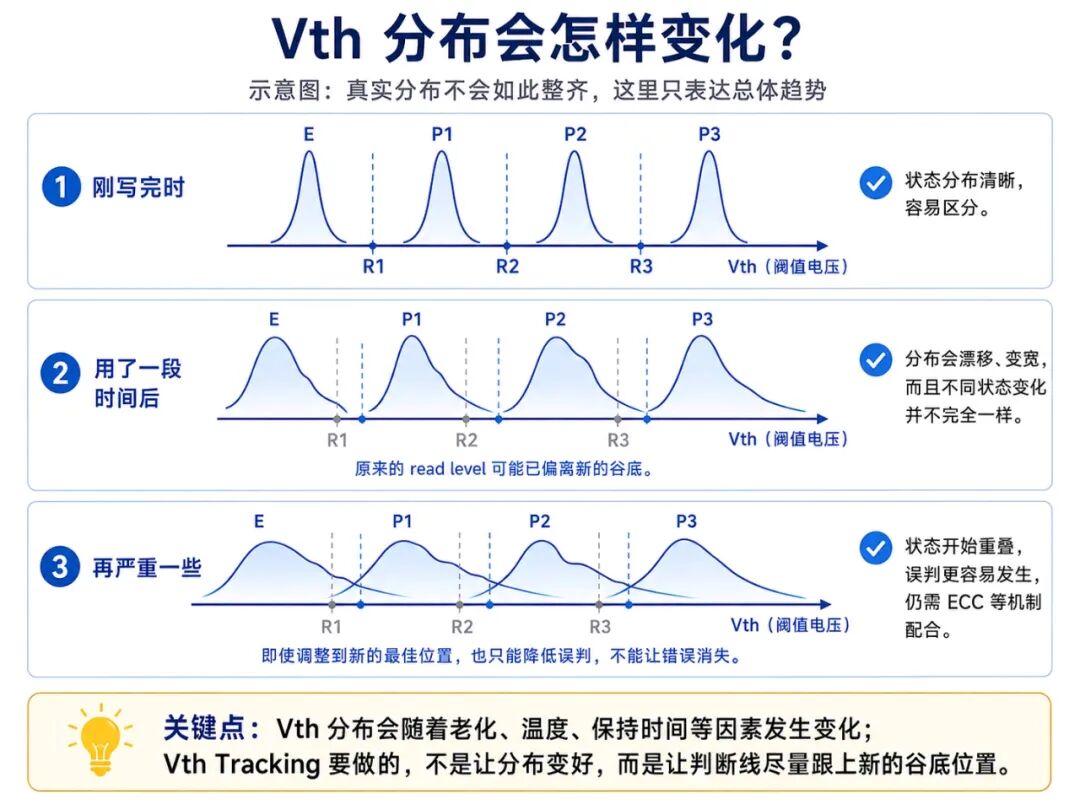
一旦状态开始重叠,SSD 再用原来的 read level 去切,就容易切错。
这就是 bit error 的来源之一。
四、默认 read level 为什么会失效?
NAND 出厂时,厂商会给出一套默认的 read level。
新盘、低 P/E、刚写完不久的数据,用默认 read level 读取,通常没什么问题。
但问题在于:
默认 read level 是静态的,而 NAND 的 Vth 分布是动态变化的。
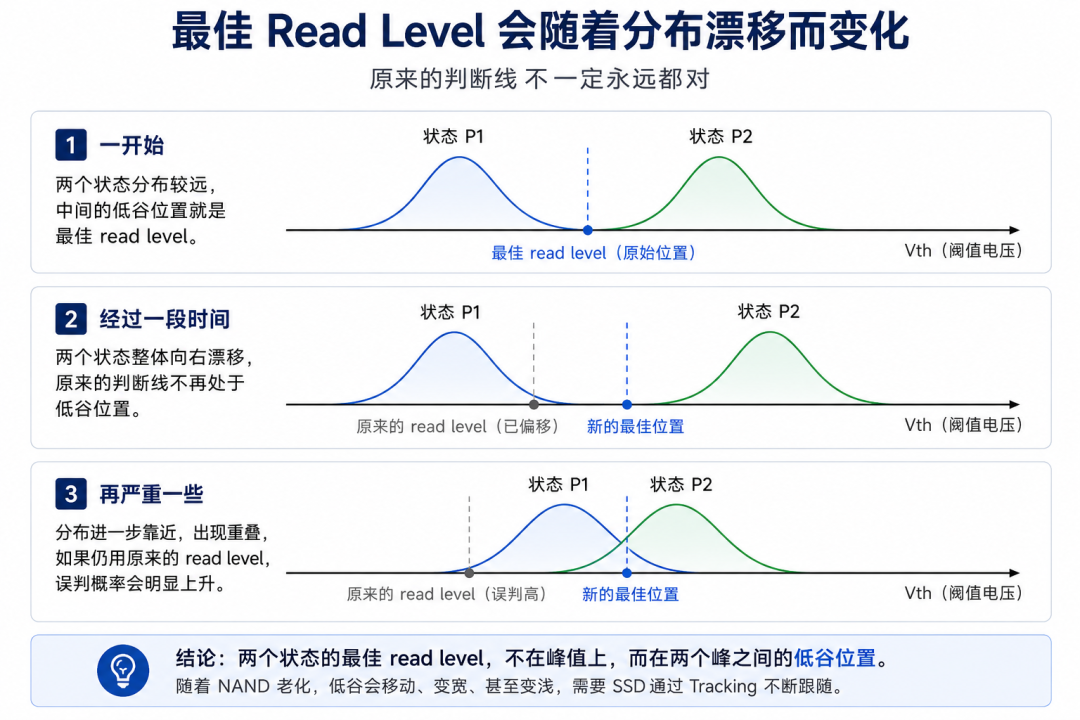
可是如果 SSD 还在用旧的判断线,就会发生误判。
这就像原来在两座山峰之间画了一条分界线。 后来山峰移动了,但你的分界线没动。 那分错地方就是早晚的事。
五、Read Retry 是抢救,Vth Tracking 是追踪
讲到这里,就可以区分两个概念了:
Read Retry:这次读失败了,我换几组read level再试试。
VthTracking:记录和预测NAND状态变化,让下次直接用更合适的read level
Read Retry 的重点是“救这一次”。
比如默认 read level 读出来,ECC 解不动。 那 SSD 就会尝试调整 read level:
默认 read level失败read level +1失败read level -1失败read level +2成功
这就是 Read Retry。
但如果每次都靠 Read Retry,代价很高。
因为每多 retry 一次,就多一次 NAND read。 读延迟会上升,性能会抖动,功耗也会增加。
所以更好的办法不是每次都临时猜,而是:
既然这块 NAND 的最佳 read level 已经偏了,那我能不能把这个偏移趋势记下来?
这就是 Vth Tracking 的意义。
六、Vth Tracking 到底在 tracking 什么?
Vth Tracking 不是直接去测每一个 cell 的真实 Vth。
这在 SSD 运行时不现实。
它真正追踪的是:
某个 block、某个 wordline、某类页面,在当前老化程度和环境条件下,更适合用哪一组 read level。
也就是说,它追踪的是“最佳读取位置”的变化。
可以理解为:
原始 read level:R1, R2, R3, R4, R5, R6, R7经过 tracking 后:R1+Δ1, R2+Δ2, R3+Δ3, R4+Δ4,...
这里的 Δ,就是偏移量。
这些偏移量可能和很多因素有关:
P/E cycleblock ageretention timetemperaturewordline 位置page type历史retry结果ECC 错误 bit 数
不同厂商、不同主控、不同 NAND,对这些信息的使用方式都不一样。
但核心思想是一样的:
不要一直用固定 read level,而是让 read level 跟着 NAND 的状态变化一起调整。
七、SSD 怎么知道 read level 偏了?
SSD 不会凭空知道。它通常要靠读取结果反推。最直接的线索是 ECC。
比如某个 page 用默认 read level 读取后,ECC 虽然成功纠错了,但发现错误 bit 很多。
这说明什么?
说明这次虽然救回来了,但读得并不舒服。
如果错误 bit 很少:
ECC corrected bits =5
说明 read level 还比较准。
如果错误 bit 很多:
ECC corrected bits =80
说明 read level 可能已经不太合适了。
如果已经接近 ECC 能力上限,那就更危险:
ECC corrected bits =190ECC capability =200
这次能读回来,不代表下次还能读回来。
所以 SSD 可以根据 ECC 的纠错数量,判断当前 read level 的健康程度。
更进一步,SSD 还可以用不同 read level 试读,观察哪一组 read level 产生的错误更少。
比如:
R默认:ECC corrected bits = 120R+1:ECC corrected bits = 70R+2:ECC corrected bits = 40R+3:ECC corrected bits = 65
那么 SSD 大概率会认为:
R+2更接近当前最佳 read level
这个过程,本质上就是在找 Vth 分布之间新的谷底位置。
八、为什么是找“谷底”?
两个状态之间,最适合放 read level 的地方,不是某个状态峰值上,而是两个峰之间的低谷。
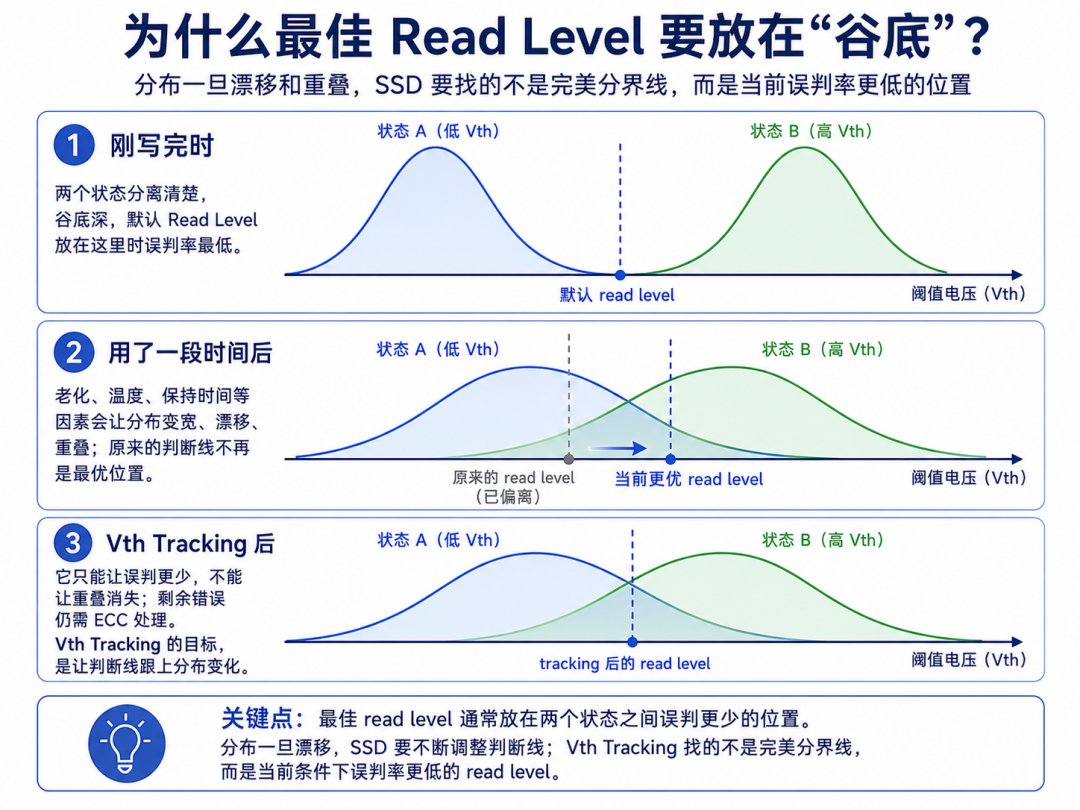
Vth Tracking 要做的,就是尽量追踪这个低谷的位置。
所以它不是简单地说:
所有 read level 都加 1。
真实情况更复杂。
不同状态之间的 read level,偏移方向和偏移幅度可能不一样。
低 Vth 状态可能偏一点,高 Vth 状态可能偏另一点。 不同 wordline 位置也可能不一样。 不同 P/E 次数下也可能不一样。
所以 Vth Tracking 不是一个简单的常数补偿,而是一套动态校准机制。
九、Vth Tracking 和 Read Retry 的关系
可以把两者关系理解成这样:
ReadRetry负责试错VthTracking负责记忆和预测
一次 Read Retry 成功以后,SSD 不一定只是把数据返回给主机就结束。
它还可能把这次 retry 的结果记录下来。
比如:
1. 这个 block 最近默认 read level 不太好用
2. 这个 WL 用 R+2更容易读回来
3. 这个 page type 在高 P/E 后需要更大的偏移
4. 这个温度范围下 read level 需要调整
这些信息可以帮助后续读取。
下一次读同一个 block 或类似条件的数据时,就不必从默认 read level 开始傻试,而是直接使用更接近最佳值的 read level。
这就是 Vth Tracking 的价值。
它让 SSD 从“每次都临时抢救”,变成“根据历史经验提前校准”。
十、Vth Tracking 不是为了炫技,而是为了降低尾延迟
从用户角度看,Vth Tracking 最直接的价值不是“读得更科学”,而是:
减少 Read Retry 次数,降低读延迟抖动。
普通读延迟可能很低。但一旦触发多次 Read Retry,延迟可能明显上升。这会形成所谓的 long tail latency,也就是尾延迟。平均延迟看起来还行,但偶尔某些读请求特别慢。
对普通家用电脑来说,可能表现为偶发卡顿。 对企业级 SSD 来说,这就是很严重的问题。 因为数据库、存储系统、虚拟化环境都很怕尾延迟。
所以 Vth Tracking 的一个重要目标就是:
少retry早命中少抖动提高读稳定性
它不一定让每一次读取都更快,但它能减少那些特别慢的读取。
十一、Vth Tracking 也能保护 ECC 余量
ECC 不是无限强的。
如果一个 page 有 200 个 bit 错误,而 ECC 最多只能纠 220 个,那这次虽然成功了,但已经很危险。
这就像考试刚好压线及格。
你不能因为这次过了,就认为没问题。
因为下次温度变了、放置时间更长了、read disturb 更多了,错误 bit 可能就超过 ECC 能力。
Vth Tracking 的意义之一,就是尽量把读取点调到更合理的位置,让原始 bit error 降下来。
比如:
默认 read level:raw bit error =180tracking 后 read level:raw bit error =80
这样 ECC 的压力就小很多。
ECC 压力小,就意味着数据安全余量更大。
所以 Vth Tracking 不是替代 ECC,而是帮 ECC 减负。
关系可以这样看:
VthTracking:尽量读得更准ECC:把剩下的错误修回来ReadRetry:读不准时临时换角度再读TestRead
:发现数据越来越危险时,搬到更健康的位置
十二、Vth Tracking 和 Test Read的关系
如果某个 block 经常需要很大的 read level 偏移才能读回来,说明它已经不太健康。
比如:
默认 read:失败retry+1:失败retry+2:勉强成功ECC corrected bits 很高
这种数据虽然还能读,但已经接近危险区。
这时 SSD 可能会触发 Test Read。
Test Read的意思是:
趁现在还能读出来,赶紧把数据搬到新的 block 里。
所以 Vth Tracking 不只是为了读这一次,它也可以给后台管理提供信号。
它可以告诉 SSD:
这个block的Vth分布已经偏得比较厉害
这个数据继续放下去风险变大
这个区域后续要重点关注
然后 FTL 或后台管理模块可以做决策:
是否搬迁数据是否降低使用频率是否加入坏块候选观察是否调整 refresh 策略
从这个角度看,Vth Tracking 是 NAND 健康管理的一部分。
十三、Vth Tracking 为什么在 TLC / QLC 上更重要?
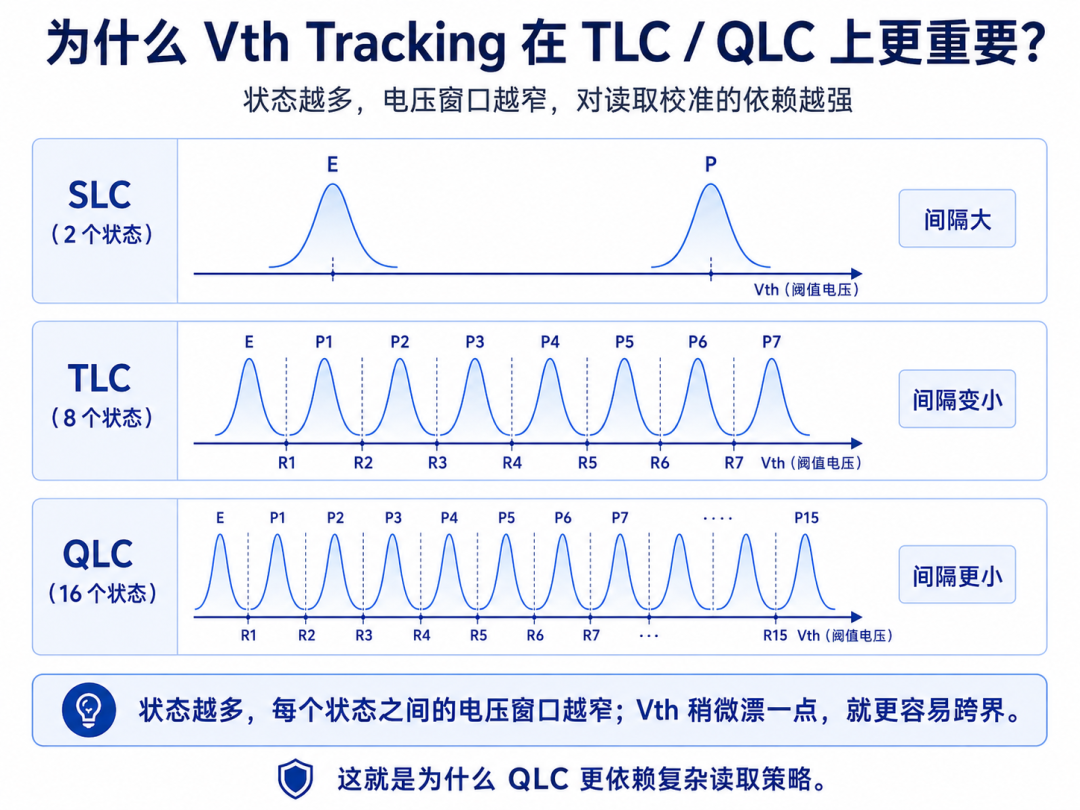
状态越多,每个状态之间的电压窗口越窄。
窗口越窄,Vth 稍微漂一点,就更容易跨界。
这就是为什么 QLC 更依赖复杂读取策略。
QLC 并不是“不能用”。但它对控制器能力、ECC 能力、read retry 策略、Vth tracking、后台数据管理的依赖更强。所以很多人只从“QLC 擦写寿命低”理解 QLC,其实是不够的。QLC 的难点不只是写多少次,还包括:
状态更多窗口更窄读取更难错误率更敏感更依赖控制器算法
Vth Tracking 就是这些算法中的重要一环。
十四、那 Vth Tracking 是前台做,还是后台做?
两种都有可能。
一种是前台触发。
也就是主机真的来读某个数据,SSD 发现默认 read level 不好用,于是触发 retry。 retry 成功后,顺手更新 tracking 信息。
流程大概是:
主机读数据↓NAND read↓ECC decode↓错误很多或失败↓ReadRetry↓找到更好的 read level↓更新Vth tracking 信息↓返回数据
另一种是后台校准。
SSD 在空闲时,可能会挑一些 block 或 page 做采样读取,观察当前 read level 是否仍然合适。
流程可能是:
后台扫描↓采样读取↓统计 ECC 错误↓估计 read level 偏移↓更新 tracking 参数
前台方式更直接,但会影响用户请求延迟。 后台方式更平滑,但会消耗内部带宽和功耗。
所以工程上要权衡:
校准太少:read level 跟不上Vth漂移
校准太多:浪费带宽、影响性能、增加读 disturb
真正的 SSD 固件,不会无限制地 tracking。 它一定要控制频率、范围和触发条件。
十五、Vth Tracking 不是越频繁越好
这点很重要。
很多机制听起来很好,但在 SSD 里不能无脑使用。
Vth Tracking 也一样。
因为 tracking 本身需要额外读取、统计和计算。
如果你为了追踪 Vth,把 NAND 反复读很多遍,可能会带来几个问题:
增加内部读放大增加功耗占用 NAND bandwidth影响前台 IO增加 read disturb 风险固件复杂度上升
所以 Vth Tracking 的难点不是“能不能追踪”。
真正难的是:
在性能、寿命、功耗、可靠性之间找到平衡。
这也是 SSD 固件有意思的地方。
很多机制不是单点技术,而是系统工程。
十六、可以把 Vth Tracking 理解成 SSD 的“动态调焦”
一个比较形象的比喻是相机对焦。
NAND 的 Vth 分布就像被拍摄的物体。 read level 就像相机的焦点。 ECC 就像后期修图。 Read Retry 就像发现照片糊了以后重新对焦再拍一张。 Vth Tracking 则是自动对焦系统。
刚开始,对焦位置是准的。
但随着物体移动、光线变化、镜头抖动,原来的焦点就不准了。
如果每次都拍糊了再重新对焦,效率很低。
更好的方式是:
系统持续观察画面变化,提前把焦点跟上。
这就是 Vth Tracking。
它不是在数据坏了以后才救。 它是在数据还没彻底坏之前,就尽量让读取位置跟上 NAND 状态变化。
十七、放到整个 NAND 读取链路里看
前面几篇文章串起来,完整逻辑是这样的:
更好的方式是:
1. NAND 不是完美数字器件
↓
2.数据以Vth分布形式存在
↓
3.读取本质是用 read level 判断Vth区间
↓
4.Vth会随着老化、温度、时间发生漂移
↓
5.默认 read level 会逐渐不准
↓
6. ECC 负责纠正读出来的 bit 错
↓
7. ECC 压力太大或失败时,ReadRetry换 read level 再试
↓
8.VthTracking记录和预测更合适的 read level
↓
9.如果数据已经越来越难读,Test Read把它搬走
这就是 Vth Tracking。
所以 SSD 读数据,不是一个简单动作。
它背后是一整套救援系统:
read levelsense ampECCReadRetryVthTrackingTestReadFTL 后台管理
这些机制组合起来,才让 NAND 这种并不完美的介质,看起来像一个可靠的存储设备。
十八、Vth Tracking 最容易被误解的一点
很多人会以为:
SSD 读不出来了,才需要 Read Retry 和 Vth Tracking。
这个理解不完全对。
更准确的说法是:
SSD 在读得越来越吃力的时候,就已经需要这些机制了。
ECC 还能纠回来,不代表状态健康。 Read Retry 能救回来,也不代表数据安全。 Vth Tracking 能调回来,也不代表 block 还能长期放任不管。
这些都是信号。
一个成熟的 SSD 控制器,要看的不是“这次有没有读成功”,而是:
这次读成功用了多少代价?ECC 纠了多少 bit?有没有触发retry?retry到第几档才成功?这个 block 最近趋势是不是变差?这个数据要不要搬走?
这才是固件真正关心的问题。
十九、结尾:SSD 不是在读取数据,而是在不断校准现实
从表面看,主机只是发了一个 read 命令。
但 SSD 内部真正发生的是:
先用当前 read level 试读再用 ECC 判断读得准不准不准就ReadRetry成功后更新VthTracking发现风险变大就TestRead
所以 SSD 不是机械地把数据读出来。
它是在一个不断老化、漂移、受干扰的模拟世界里,持续寻找最合理的判断线。
这就是 Vth Tracking 的本质:
NAND 的状态一直在变,SSD 必须跟着变。 否则,昨天正确的 read level,今天就可能变成错误的判断线。
Read Retry 解决的是“这一次怎么救回来”。 Vth Tracking 解决的是“下一次怎么不要再从头试错”。
这也是 NAND 存储最有意思的地方:
数据并不是安静地躺在那里等你读取。 它一直在变。 SSD 要做的,就是在变化中,把它重新判断出来。
 Alipay
 Wechat