前面我们讲过 Read Retry,也讲过 Soft Read。
Read Retry 的核心,是移动 read level。 也就是换几条判断线,再重新读一次 NAND。
Soft Read 的核心,是在默认判断线附近多读几次,告诉 LDPC:
哪些 bit 比较可靠,哪些 bit 可能只是擦边猜出来的。
这已经比普通 Hard Read 更进一步了。
Hard Read 只告诉 ECC:
这个 bit 是 0,还是 1。
Soft Read 则会额外告诉 ECC:
这个 0 有多像 0? 这个 1 有多像 1? 哪些 bit 看起来很可疑?
所以 Soft Read 不是简单地“再读一遍”,而是给 LDPC 更多可靠度信息,让 LDPC 有机会做 soft decode。
但问题来了:
如果 Soft Read 都不管用了呢?
难道 SSD 就眼睁睁看着数据变错吗?
当然不是。
这时候还有一个方法,叫 RAID。
一、Soft Read 失败,说明什么?
先不要把这句话理解成:
数据彻底没救了。
更准确的说法是:
单靠这一页 NAND 自己,已经很难把数据救回来了。
Read Retry 也好,Soft Read 也好,本质上都还在围绕同一个目标:
从这一页 NAND 里面,把原来的数据尽量读出来。
Read Retry 是换判断线。 Soft Read 是多拿几次边界信息。 LDPC 是根据这些信息继续纠错。
但它们仍然有一个共同前提:
这一页 NAND 里还残留着足够多的有效信息。
如果 NAND 的阈值电压分布已经严重重叠,或者某个 page、某个 wordline、某个 block 出现了更严重的问题,那么这一页本身提供的信息就可能不够了。
这时候继续对着同一页反复读,意义会越来越小。
就像一张照片已经糊到看不清人脸了,你再调亮度、调对比度、加锐化,可能也救不回来。
这时就不能只盯着这张照片本身了。
你需要另一张照片,或者别的角度的信息,来把缺失的部分补回来。
放到 SSD 里,这个思路就是:
不要只依赖坏掉的那一份 NAND 数据,而是利用其他 NAND 位置上的数据和校验信息,把它重建出来。
这就是 RAID 思想登场的地方。
二、一开始也不懂,为什么它叫 RAID?
很多人第一次看到 RAID 这个词,都会有点懵。
它看起来像一个英文单词。 但在存储领域,RAID 严格来说不是普通单词,而是一个缩写。
RAID 最早来自:
Redundant Arrays of Inexpensive Disks
翻译过来就是:
廉价磁盘冗余阵列
后来行业里也经常把它解释成:
Redundant Array of Independent Disks
也就是:
独立磁盘冗余阵列
RAID 这个概念最早不是为 SSD 准备的,而是为机械硬盘阵列准备的。1988 年,David A. Patterson、Garth Gibson、Randy H. Katz 发表了经典论文《A Case for Redundant Arrays of Inexpensive Disks》,提出用多个相对便宜的磁盘组成阵列,并通过冗余来提高性能、可靠性和扩展性。A Case for Redundant Arrays of Inexpensive Disks.pdf
所以 RAID 这个名字,要拆开看才好理解。
三、RAID 这几个字母到底是什么意思?
R:Redundant,冗余。
意思是: 不要只存一份数据。
除了真正的用户数据之外,还要额外存一些可以用于恢复的数据。
这个额外数据,可能是完整副本,也可能是 parity 校验信息。
A:Array,阵列。
这才是你说的“阵列”。
RAID 不是让一块盘自己承担所有风险,而是把多块磁盘组织成一个整体。
数据可以分散到不同磁盘上。 校验信息也可以分散到不同磁盘上。
这样一来,某一块盘坏了,系统不一定立刻完蛋。
I:Inexpensive 或 Independent。
最早是 Inexpensive,也就是“廉价的”。
因为当年的思路是: 不用一块又大又贵的高端磁盘,而是用很多块相对便宜的小磁盘组合起来。
后来这个词逐渐变成 Independent,也就是“独立的”。
因为后来磁盘不一定廉价,重点变成了:
多个独立磁盘组成一个整体。
现在很多资料会把 RAID 解释为 Redundant Array of Independent Disks。
D:Disks,磁盘。
因为 RAID 最早面对的是 HDD,也就是机械硬盘。
所以 RAID 这个名字完整理解就是:
把多个磁盘组成一个阵列,并加入冗余信息。 当其中一部分数据坏掉时,可以靠其他成员把它恢复出来。
这就是 RAID 的核心。
不是神秘技术。也不是单纯“阵列”两个字。
它真正重要的是:
阵列 + 冗余 + 可恢复。
四、那 SSD 里为什么也会讲 RAID?
这就有意思了。
RAID 最早是给机械硬盘用的。但 SSD 里面没有机械磁盘。它里面是 NAND flash。
那为什么 SSD 里还会提 RAID?
原因很简单:
虽然存储介质变了,但问题没变。
机械硬盘会坏。 NAND 也会坏。
机械硬盘可能整盘失效。 NAND 可能某个 page、某个 block、某个 die 读不出来。
所以到了 SSD 里,RAID 的对象变了。
原来 RAID 是跨多块磁盘做冗余。 SSD 里可以跨多个 NAND die、plane、block、page,甚至 channel 做冗余。
也就是说:
HDD 时代,RAID 是磁盘之间的保护。 SSD 时代,RAID 思想可以变成 NAND 之间的保护。
有些资料会把这种机制叫 NAND RAID。 有些会叫 die RAID。 也有一些会叫 RAIN。
名字不完全一样,但底层思想接近:
不要把用户数据的生死,全部押在同一颗 NAND、同一个 block、同一个 page 上。
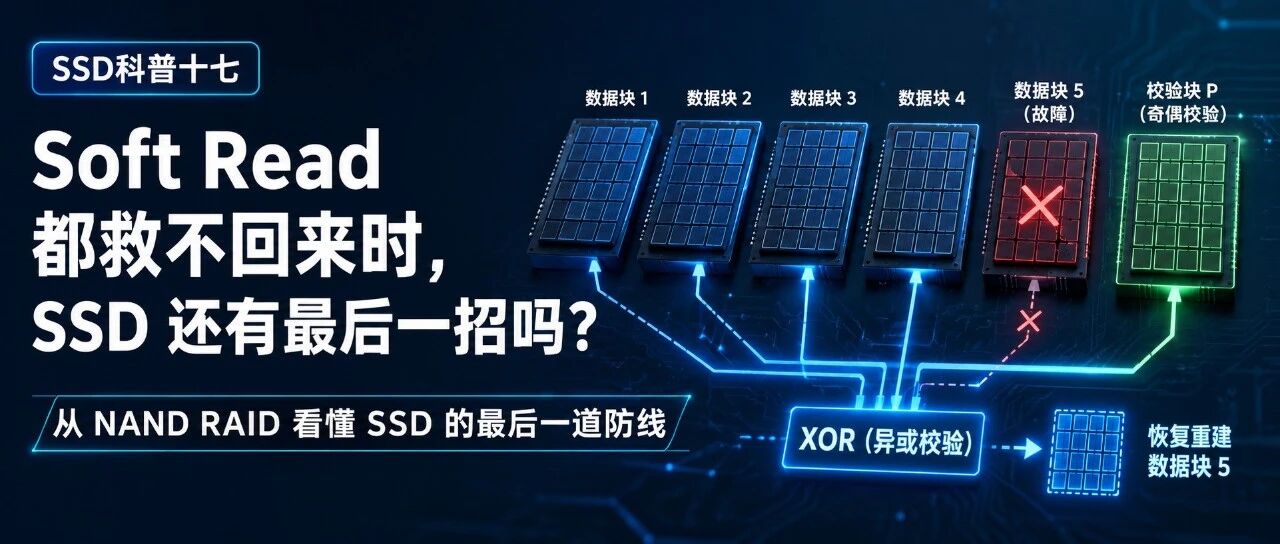
五、RAID 是怎么把数据“算回来”的?
举一个最简单的例子。
假设 SSD 写入三份数据:
A B C
然后 controller 额外计算一份 parity:
P = A XOR B XOR C
这份 P 不是用户数据。 它是为了将来恢复数据准备的。
如果有一天,B 这份数据读不出来了。
这时候 SSD 不一定马上宣告失败。
因为它还有 A、C、P。
根据 XOR 的特性,可以反过来算:
B = A XOR C XOR P
这样,B 就被重建出来了。
这就是 RAID 和 Soft Read 最大的不同。
Soft Read 是在问:
B 里面这些 bit,到底更像 0,还是更像 1?
RAID 是在问:
如果 B 这份数据已经不可信了,能不能用 A、C、P 把 B 重新算出来?
一个是继续读。 一个是直接重建。
六、所以 RAID 不是更强的 Read
这一点很关键。
很多人容易把 SSD 的恢复流程理解成:
Hard Read 不行,就 Read Retry。 Read Retry 不行,就 Soft Read。 Soft Read 不行,就更强的 Read。
但 RAID 不是“更强的 Read”。
RAID 已经换了一条路线。
Read Retry、Soft Read、LDPC,仍然是在这一页 NAND 里想办法。
它们都希望从同一个物理位置中,把原始数据读出来。
而 RAID 的思路是:
如果这一页 NAND 自己已经靠不住了,那就不要只相信它。 用别的 NAND 数据和校验信息,把它恢复出来。
这已经不是读取层面的挣扎了。 而是系统层面的冗余恢复。
七、RAID 能救数据,是因为写入时就提前准备了
这里还要注意一个问题。
RAID 不是读失败之后,controller 临时变出来的魔法。
它能救数据,是因为 SSD 在写入的时候,就已经提前做了冗余设计。
写入时,controller 可能会把数据分散写到多个 NAND 位置。同时再额外生成 parity。这些 parity 也会被写入 NAND。
等到读取时,如果其中某一份数据失败,controller 才能用其他数据和 parity 来恢复。
所以 RAID 和 ECC 有点像。
ECC 之所以能纠错,是因为写入时就生成了 ECC 校验信息。 RAID 之所以能重建,是因为写入时就生成了跨 NAND 的冗余信息。
天下没有免费的可靠性。
RAID 的代价是:
额外空间。 额外写入。 额外管理复杂度。 额外恢复时间。
但它换来的是:
当某一份 NAND 数据彻底读不出来时,SSD 还有机会把数据救回来。
八、ECC、Soft Read、RAID 的层级是不一样的
可以把它们放在一起看。
ECC 主要解决的是:
一串数据里面,有一些 bit 翻错了,能不能纠回来?
Soft Read 解决的是:
这些 bit 不是非黑即白,能不能告诉 LDPC 哪些更可疑?
RAID 解决的是:
如果这一整份数据都不可靠了,能不能靠其他 NAND 位置把它重建出来?
所以它们不是同一个层级的东西。
ECC 更像是 page 内部的纠错。 Soft Read 是给 ECC 更多判断依据。 RAID 是跨 page、跨 block、跨 die 的冗余恢复。
这也是为什么在读失败的救援链路里,RAID 往往比 Soft Read 更靠后。
因为只要 ECC 还能纠,没必要动 RAID。 只要 Soft Read + LDPC 还能救,也没必要动 RAID。
RAID 是更重的手段。
它不是第一道防线。 它更像最后一道防线。
九、为什么 SSD 不能只靠 RAID,不靠 ECC?
既然 RAID 这么强,那能不能不要 ECC,全部靠 RAID?
不行。
因为它们解决的问题不一样。
NAND 的错误通常不是一上来就整页报废。 更多时候,是 page 里出现一些 raw bit error。
比如几百个 bit、几千个 bit 出错。 这种情况最适合 ECC 来处理。
如果每次出现几个 bit 错误,都动用 RAID,那成本太高了。
读取会变慢。 写入放大会增加。 后台管理也会变复杂。
所以 SSD 的正常逻辑一定是分层的:
先用 ECC。 ECC 不够,再靠 Read Retry。 Read Retry 还不够,再靠 Soft Read 给 ECC 更多信息。 如果这条路还是失败,才考虑 RAID 这类跨 NAND 的恢复机制。
这不是谁取代谁。
而是每一层解决不同级别的问题。
十、这才是 RAID 放在 Soft Read 后面讲的原因
Soft Read 讲的是 NAND 读出来的数据还比较模糊。
它的重点是:
这个 bit 是强 0、弱 0、弱 1,还是强 1?
而 RAID 讲的是:
如果这一整份 NAND 数据已经不能信了,SSD 还能不能靠别的地方把它补回来?
所以 Soft Read 之后讲 RAID,是很自然的。
因为前面几篇文章一直在讲:
SSD 是怎么从不可靠的 NAND 里,把数据读对的?
到 RAID 这一篇,问题就升级了:
如果 NAND 自己已经读不对了,SSD 还能不能用系统级冗余把数据救回来?
这时,SSD 不再只依赖单个 page 的物理读出结果。 它开始依赖整个 SSD 内部的数据布局和冗余关系。
这就是 RAID 的价值。
十一、总结
当 Soft Read 都不管用时,并不是 SSD 就立刻放弃数据。
更准确地说:
单靠这一页 NAND 自己,已经救不回来了。
这时候 SSD 还有可能动用 RAID 思想。
RAID 最早来自机械硬盘阵列。 它的核心不是“阵列”两个字,而是:
冗余阵列。
也就是:
数据不要只放在一个地方。 要提前准备冗余信息。 当其中一份坏掉时,可以靠其他部分把它恢复出来。
放到 SSD 里,RAID 的对象从磁盘变成了 NAND。
它可以跨 die、跨 block、跨 page、跨 channel 做冗余。
所以一句话总结就是:
ECC 是在一页数据内部纠错。Soft Read 是给 LDPC 更多可靠度信息。RAID 是当这一页数据已经救不回来时,用跨 NAND 的冗余关系把它重建出来。
这也是 SSD 可靠性的真正含义。
不是 NAND 本身永远不出错。 而是 NAND 出错之后,SSD 还有一层又一层的办法,把数据尽量救回来。
谢谢你看我的文章
 Alipay
 Wechat