前面写了很多 NAND 的内容,从 Cell、Program、Erase,到 Read、Read Retry、Multi-Plane,这些内容大多是在讲 NAND 内部发生了什么。
但如果把视角往外拉一步,会遇到一个更基础的问题:SSD Controller 到底是怎么和 NAND 通信的?
Controller 想让 NAND 执行 Read、Program 或 Erase,需要把 Command 发给 NAND;想访问某个 Page,需要把 Address 告诉 NAND;真正读写数据的时候,又需要把 Data 在 Controller 和 NAND 之间传输。而这些事情,最终都要通过 NAND 芯片外面的一根根引脚完成。
所以这一篇,我们先不往 NAND 内部走,而是从 NAND 的引脚说起。
一、先认识NAND的几个基本引脚
不同厂商、不同代际、不同 Interface Mode 的 NAND,具体 Pin 定义会有所区别。如果先从最基本的 NAND 接口来看,常见的几组信号包括:
• CE#:Chip Enable,用来选择 NAND • CLE:Command Latch Enable,用来指示当前 DQ 上的是 Command • ALE:Address Latch Enable,用来指示当前 DQ 上的是 Address • WE#:Write Enable,用来配合锁存 Controller 送进 NAND 的内容 • RE#:Read Enable,主要用于控制 NAND 的数据输出 • R/B#:Ready/Busy,用来告诉 Controller NAND 当前是 Ready 还是 Busy • WP#:Write Protect,用于 Program、Erase 的写保护 • DQ[7:0]:Data I/O,用来传输 Command、Address 和 Data
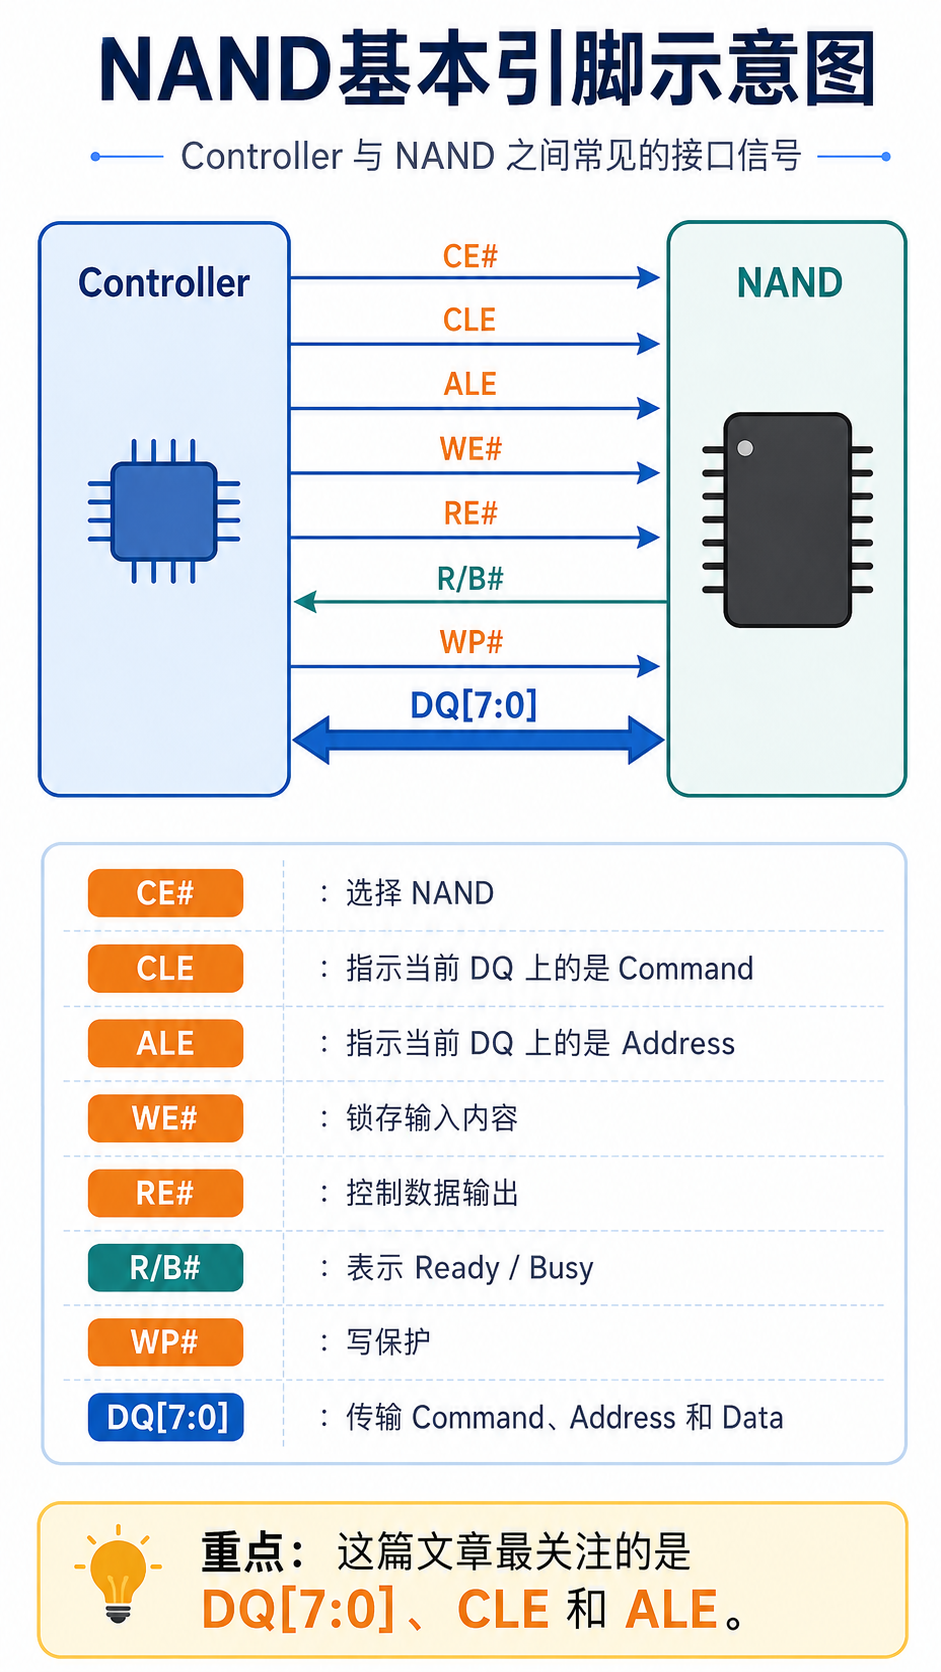
这些信号里,这篇文章真正想讲的是 DQ[7:0]、CLE 和 ALE。因为只要仔细看这组 Pin,就会发现一个很奇怪的问题:
NAND 的地址引脚去哪了?
二、NAND的地址引脚去哪了?
我们已经知道,NAND 内部有很多 Block,每个 Block 里又有很多 Page。Controller 想读取某一份数据,首先必须告诉 NAND:我要访问的是哪一个位置。
这个“位置”,本质上就是 Address。
在很多数字存储器或者数字芯片里,这类位置信息通常会通过专门的 Address Pin 送进去。比如 A0、A1、A2、A3……这些引脚共同组成 Address Bus,地址中的每一位通过不同的 Address Pin 送入芯片,芯片再根据这些地址信息选择内部对应的位置。
如果按照这种思路来看,NAND 既然同样需要区分不同的 Block、Page,以及 Page 内部的位置,似乎也应该有一组专门的 Address Pin。
但是再看 NAND 的 Pinout,却会发现:并没有 A0、A1、A2……这样一组独立的 Address Bus。
那 NAND 的地址到底从哪里送进去?
答案是:还是从 DQ[7:0] 进去。
而且不只是 Address。Command 也是从 DQ[7:0] 进去的,真正的 Data,同样还是通过 DQ[7:0] 传输。
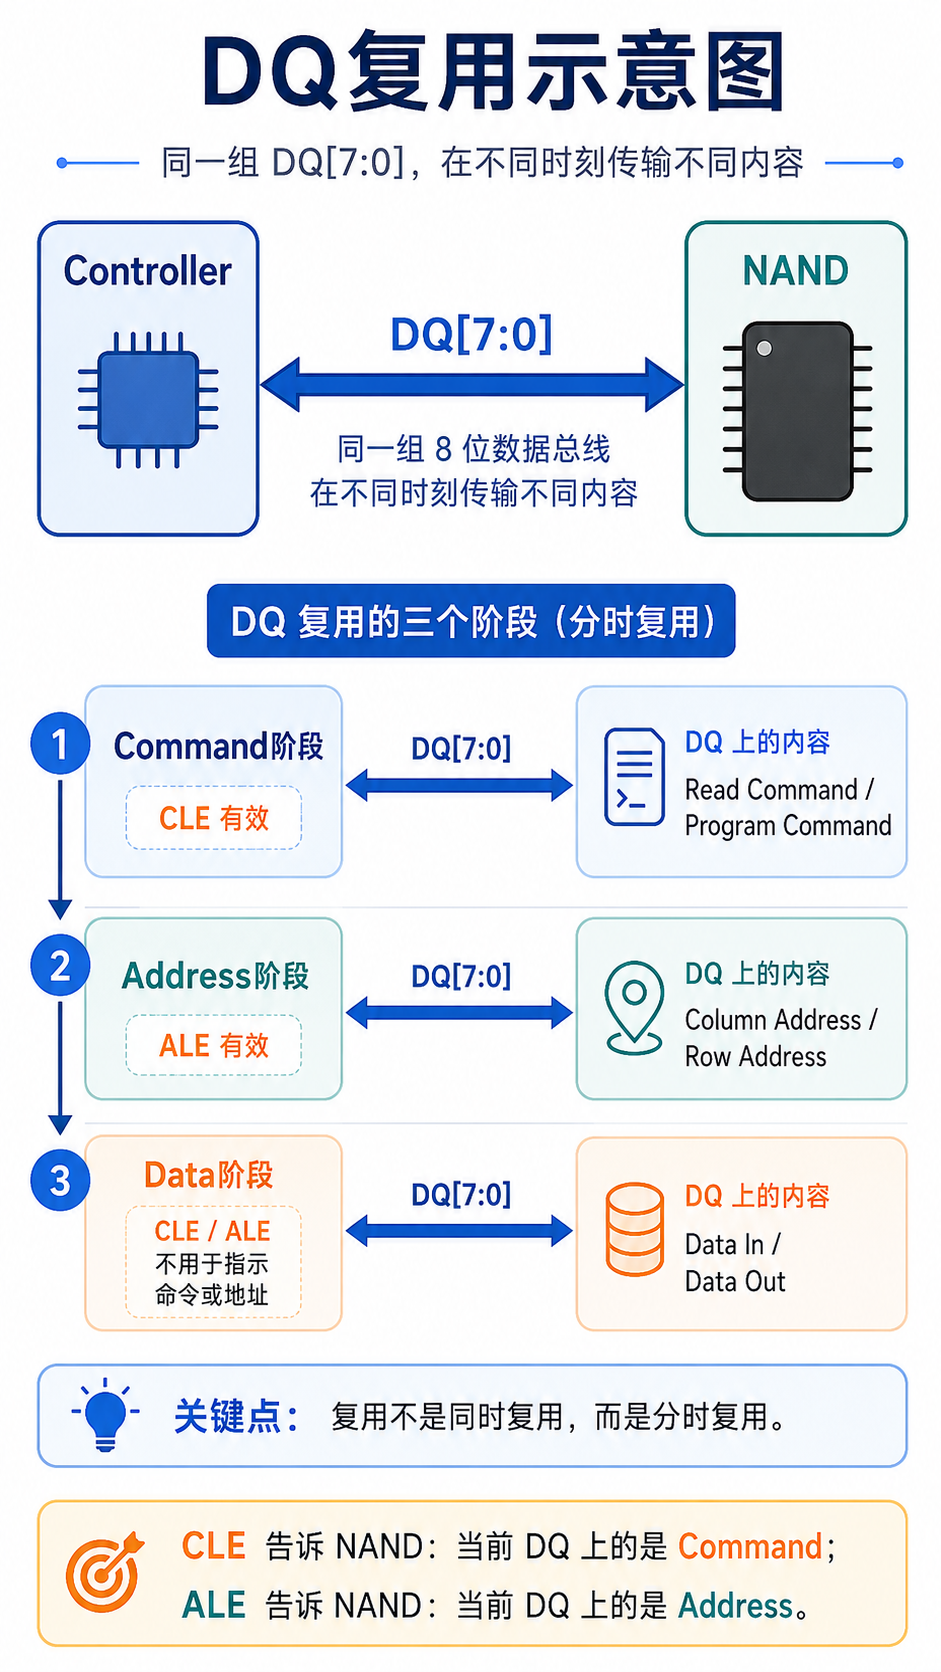
也就是说,同样这一组 DQ,在不同时间承担了三种工作:Command、Address、Data。
这时候问题就来了:既然都是从 DQ 进去,NAND 怎么知道现在 DQ 上的是 Command,还是 Address?
这就是 CLE 和 ALE 存在的意义。
三、CLE和ALE到底是干什么的?
CLE 的全称是 Command Latch Enable,ALE 的全称是 Address Latch Enable。
当 Controller 要发送 Command 时,会让 CLE 处于有效状态。这时候 NAND 就知道,当前 DQ[7:0] 上的内容应该被当成 Command。
如果接下来 Controller 要发送 Address,则让 ALE 有效。NAND 就知道,当前 DQ[7:0] 上的内容应该被当成 Address。
所以可以简单理解成:
CLE 有效:DQ[7:0] → Command
ALE 有效:DQ[7:0] → Address
Data 阶段:DQ[7:0] → Data
这里有一点很重要:CLE 和 ALE 本身并不传 Command 和 Address。
真正承载这些信息的,还是 DQ。CLE 和 ALE 更像是在告诉 NAND:现在应该怎样理解 DQ 上的内容。
这也是为什么它们叫 Latch Enable。
四、以一次Read为例
拿一次最基本的 NAND Read 来看会更直观。
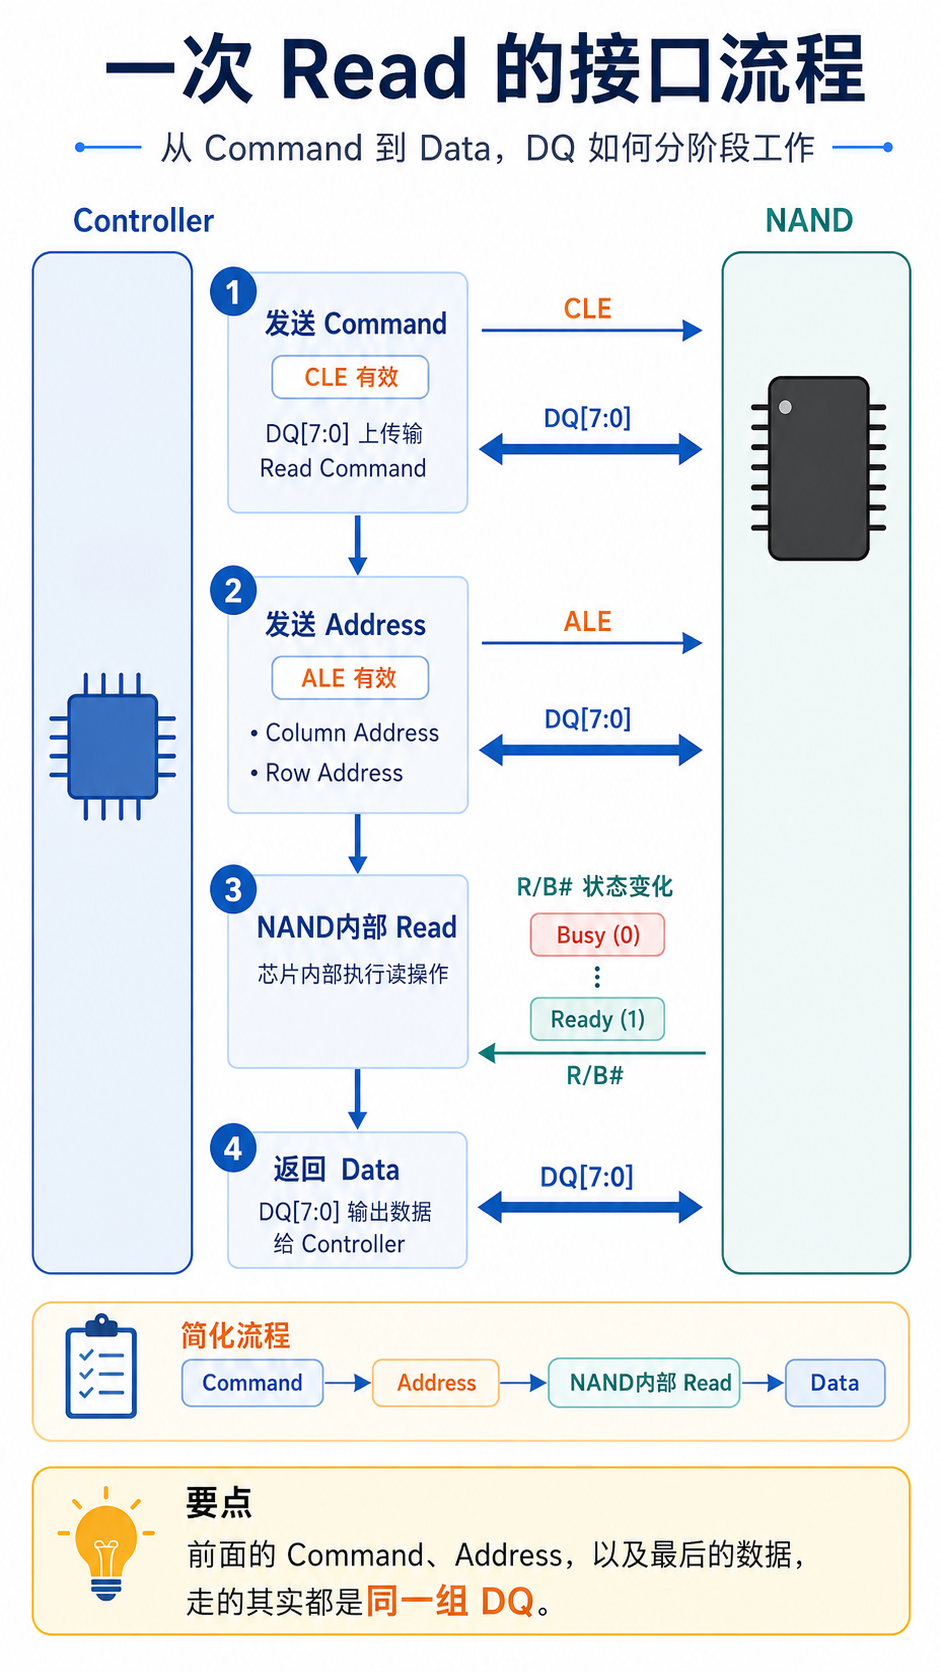
首先,Controller 要告诉 NAND:我要执行一次 Read。于是先通过 DQ 发送 Read Command,此时 CLE 有效。
接下来,Controller 还需要告诉 NAND:我要读哪里。于是进入 Address 阶段,这时候 ALE 有效,DQ 上开始依次传输 Address。
这些 Address 通常还会继续分成 Column Address 和 Row Address。这里先简单理解就可以:Column Address 决定 Page 内部的位置,Row Address 决定要访问哪一个 Page。
Address 发送完成之后,NAND 才会开始执行内部 Read。等内部 Read 完成以后,真正的数据再通过 DQ 返回给 Controller。
所以单纯从接口这一层看,一次 Read 大致可以理解成:
Command
↓
Address
↓
NAND内部Read
↓
Data
有意思的地方就在这里:前面的 Command、Address,以及最后真正的数据,走的其实都是同一组 DQ,只是发生在不同时间。
五、为什么不直接多搞一些引脚?
看到这里,很自然会产生另一个问题:既然 Command、Address 和 Data 本来就是三种不同的信息,为什么不干脆给它们各自准备独立的线路?
比如 Data Bus 一组,Address Bus 一组,Command Bus 再来一组。这样想发 Command 就走 Command Bus,想发 Address 就走 Address Bus,想传 Data 就走 Data Bus,不是更直接吗?
从电路上说,当然可以。
但问题在于:不划算。
NAND 的地址并不短。随着 NAND 容量不断增大,需要区分越来越多的 Block 和 Page,完整地址会越来越长。如果把这些 Address Bit 全部做成独立物理引脚,再给 Command 单独准备一组线路,那么整个 NAND 的 Pin Count 会明显增加。
而现在这种方式,只需要一组 DQ,再加上 CLE 和 ALE,就可以让 Command、Address 和 Data 共用同一套物理线路。
所以 CLE 和 ALE 看起来像是额外增加了两根控制线,但实际上它们的作用恰恰是:
用很少的控制 Pin,省掉更多专用 Pin。
六、为什么这种复用特别适合NAND?
如果只是为了少几根 Pin,其实还不足以解释为什么这套设计会长期存在。更关键的是,Command、Address 和 Data 的传输量根本不在一个数量级上。
一次 NAND 操作开始时,Controller 需要发送的可能只是少量 Command 和少量 Address,但后面真正传输的数据,却可能是一整个 Page。
也就是说,一次操作大致是:
少量 Command
↓
少量 Address
↓
NAND内部操作
↓
大量 Data
真正需要大量接口带宽的是 Data。Command 和 Address 只在一次 Operation 开始时短暂出现。
如果为了这些只使用几个 Cycle 的信息,长期准备一整套独立的 Address Pin 和 Command Pin,那么在真正大量传输 Data 的时候,这些 Pin 大部分时间都处于闲置状态。
这就不太划算。
NAND 于是选择了另外一种方式:让低占用率的 Command 和 Address,与 Data 共用 DQ。
付出的代价,是多花几个 Cycle 发送 Command 和 Address;换来的,则是更低的 Pin Count。
这其实是一种很典型的工程取舍:
用少量时间,换长期存在的硬件资源。
七、容量越来越大,为什么Pin没有跟着一直增加?
地址复用还有一个很实际的好处。
假设 NAND 使用独立 Address Bus,那么 NAND 容量增大以后,需要更多 Address Bit。Address Bit 增多,就可能意味着 Address Pin 也要继续增加。这样每次 NAND 容量升级,都可能影响封装、Controller 和 PCB。
但地址复用以后就不一样了。
NAND 内部可以继续增加更多 Block、更多 Page、更大的地址空间,而外面仍然可以继续使用原来的 DQ[7:0]。
地址变长怎么办?
很简单:多发一个 Address Cycle。
所以 NAND 内部容量增加以后,并不一定需要同步增加外部 Address Pin。
某种程度上可以说:
地址复用把 NAND 内部容量增长和外部 Pin Count 解耦了。
这对于 NAND 这种容量不断增长的存储器件非常重要。
八、为什么不同厂家后来都愿意这么做?
再往后想一步,还会有一个问题:如果这只是某一家 NAND 厂商的设计选择,为什么后来很多厂商都采用了类似的接口思路?
一开始,原因很简单:这种设计本身就适合 NAND。 它减少了 Pin Count,又没有付出太大的性能代价。
但等越来越多 NAND、Controller、封装、PCB、测试设备都围绕这种接口设计以后,事情就不只是“省 Pin”这么简单了,这时候又多了一个更重要的价值:
兼容性。
试想一下,如果每家 NAND 厂商都有完全不同的接口,A 厂使用独立 Address Bus,B 厂使用 DQ 复用,C 厂又使用另一套 Command Bus,D 厂的 Pinout 和 Timing 全都不一样,那么 Controller 厂商就要为不同 NAND 准备不同的接口。
SSD 厂商换一颗 NAND,可能连 PCB、Controller Pinout 和测试平台都要跟着变,整个产业链的成本都会明显增加。
反过来,如果大家在最基本的接口思路上保持一致,例如 DQ、CLE、ALE、CE#、RE#、WE#、R/B# 等基本信号保持类似,那么即使不同 NAND 在具体 Command、Timing、Feature 上仍然存在差异,至少最底层的连接方式可以保持相对稳定。
所以这套设计一开始是一个合理的工程选择,后来则进一步变成了整个产业链共同的接口基础。
九、后来有了ONFI和Toggle
随着 NAND 速度不断提高,接口也需要继续演进。
但真正需要解决的问题并不是:要不要把 Address 单独拉出来?
而是:
怎样让 DQ 上的数据传得更快?
于是后来的 NAND Interface 开始不断提高 I/O Rate,引入 DDR、DQS 等高速传输机制。现在经常看到的两套主要接口体系,就是 ONFI 和 Toggle Mode。
这里有一点很容易误解。
并不是 ONFI 或 Toggle 发明了 CLE、ALE,也不是它们发明了 DQ 复用 Command、Address 和 Data。这些基本接口思想在更早的 NAND 中就已经存在了。
ONFI 和 Toggle 更像是在这套基本结构上继续解决接口如何标准化、数据如何高速传输、Timing 如何定义,以及高速模式如何工作等问题。
所以即使 NAND 从早期异步接口一路发展到后来的高速 DDR 接口,仍然能看到熟悉的 CLE、ALE 和 DQ。
变化最大的,是 Data 的传输方式越来越快,而不是重新增加一大排独立 Address Pin。
十、从几个引脚,看NAND的设计取舍
如果只看 datasheet,我们很容易把:
CLE = Command Latch Enable
ALE = Address Latch Enable
记下来,然后继续往后看。
但如果多问几个为什么,就会发现,这两个 Pin 后面其实藏着 NAND Interface 很完整的一套设计逻辑。
为什么需要 CLE 和 ALE?因为 Command 和 Address 都没有独立的总线,而是和 Data 共用 DQ。CLE 用来告诉 NAND 当前 DQ 上的是 Command,ALE 用来告诉 NAND 当前 DQ 上的是 Address。
为什么三者要共用 DQ?因为 Command 和 Address 的传输量很小,而真正占用接口带宽的是后面大量的数据。既然 Address 和 Command 只在少数几个 Cycle 出现,就没有必要为它们长期准备大量独立物理线路。
于是 NAND 做了一个很典型的取舍:
少量额外的 Command / Address Cycle
换
更少的物理引脚
这种设计不仅减少了 Pin Count,也让 NAND 容量继续增长时,不需要让 Address Pin 数量跟着不断增加。
后来 NAND 接口一路发展到 ONFI、Toggle,速度越来越高,DQS、DDR 等机制不断加入,但 CLE、ALE 和 DQ 复用这种基本思想一直被保留了下来。
因为真正需要大量带宽的,从来都不是前面那几个 Byte 的 Command 和 Address。
而是后面真正要传输的那些数据。
 支付宝
 微信