一个SSD Firmware工程师的真实排查:为什么我最后怀疑到了SSD内部?
【SSD科普系列 35】
电脑放久了不用,重新开机以后突然变得特别卡——你的第一反应可能是内存不足、系统负载太高,甚至怀疑这台机器是不是已经出了问题。
但作为一个SSD固件工程师,我想带你看看另一种可能:卡顿的根源不一定在操作系统,也可能在你那块很久没通电的SSD内部——它可能正在后台忙着"维护"自己的数据。
前两天,同事找到了一台很久没有开机的电脑,准备重新作为测试机使用。由于这台机器长期没有使用,重新启动以后需要重新配置环境、下载一些测试包,我给他发了一些平时测试环境里常用的命令。
但在执行 wget 下载测试包的时候,发现速度非常慢。我的第一反应是测试包服务器或者下载地址出了问题,于是问另一个同事:"这个测试包的下载链接是不是变了?"得到的回复是:"没有变,之前一直都是这个地址。"
这时候问题反而变得奇怪了。如果只是下载地址或网络问题,理论上应该只影响下载速度,但实际情况是整台机器的操作都非常迟缓。我远程连过去看,输入一条命令,经常要等很久才有响应。
到这里,问题的范围就缩小了:它不像是网络问题,更像是这台机器本身存在某种资源瓶颈。接下来就是标准的排查流程。
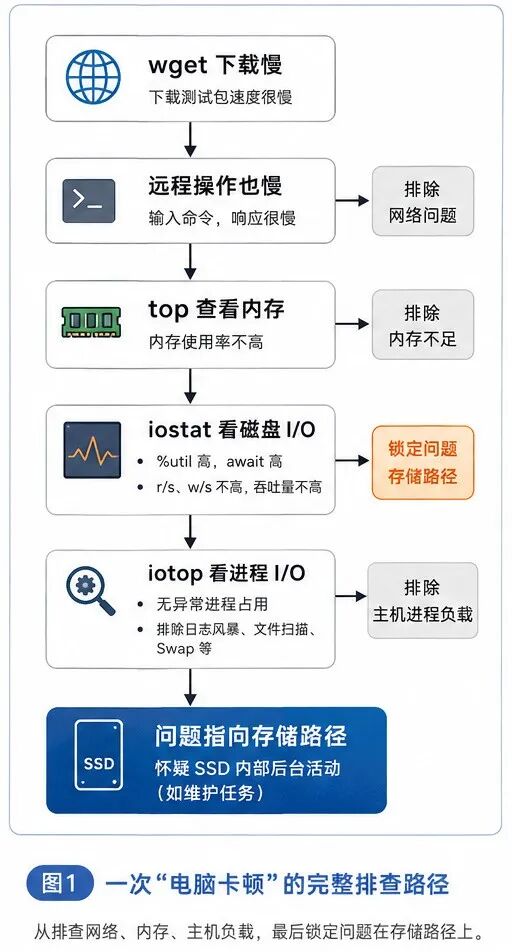
一、先排除最常见的原因:内存不足
Linux 系统卡顿时,很多人的第一反应是"内存满了"。这个判断方向没有错:当系统可用内存不足时,Linux 会启用 Swap,把一部分本该放在内存里的数据换到磁盘上——相当于内存不够时,系统把SSD当作临时仓库来用。而SSD的访问延迟远高于内存,大量 Swap 活动就会导致命令执行延迟、程序启动变慢。
第一步,查看系统状态:
$ top结果发现,内存使用率并不高,系统没有明显的内存压力。可以初步排除:这次卡顿不是内存不足导致的。
二、真正异常的,是磁盘 I/O
既然 CPU 和内存都没问题,就继续往下看存储。这里要先区分两个容易混淆的概念:很多人说的"磁盘占用高",指的是磁盘空间快满了,用 df -h 就能看到;而这次要关注的是磁盘 I/O 是否长期处于繁忙状态——主机侧的 I/O 长时间没有得到及时完成。
继续观察块设备的实时状态:
$ iostat -x 1这个命令里比较重要的几个指标:%util(设备忙碌程度)、await(每个I/O的平均等待时间)、r/s 和 w/s(每秒读写请求数量)。这台机器的表现很典型:NVMe 设备长时间处于高忙碌状态,await 也明显偏高。
先说结论:到这里,问题已经基本可以确定——至少落在了存储路径上。 接下来要做的,只是把"是谁在拖慢存储"再收窄一点:是主机自己在疯狂读写,还是设备自身出了状况。
先排除前者。如果 r/s、w/s 和数据吞吐量都不高,说明并不是主机在读写什么大东西,而是每一笔 I/O 都要等很久才能返回。如果要进一步确认是哪些进程在访问磁盘,还可以从进程角度看一眼:
$ sudo iotop这样可以继续排除日志风暴、文件系统扫描、Swap 这一类主机侧负载。
那为什么主机请求不多、设备却这么忙?这里顺便澄清一个很多文章都会写错的知识点:iostat、/proc/diskstats 这些主机侧统计,记录的只是主机发出去的块设备 I/O。SSD 内部的垃圾回收、数据搬移、可靠性维护,并不会作为一条新的 Linux I/O 出现在操作系统里。
那它们的影响是怎么体现的?答案是间接的:内部任务占用了 NAND 和控制器的处理能力,主机 I/O 的完成时间被拉长,于是 await 上升、设备长期挂着未完成的请求——在主机看来,就是"磁盘很忙"。
至于具体是不是 SSD 内部后台任务在"抢资源",还需要结合设备的行为继续判断。
排查到这里,操作系统层面能给的信息基本用尽了。接下来,该轮到固件工程师的视角登场了。
三、看到 SSD 很忙,固件工程师会想到什么?
普通用户看到"磁盘占用很高",第一反应可能是"SSD是不是坏了"。但固件工程师会继续往下想:SSD 内部是不是正在执行某些后台任务?
现代 SSD 并不是一个简单的数据存储设备。从电脑的角度看,SSD 好像只干三件事:读数据、写数据、返回结果。但在 SSD 控制器内部,还有大量固件逻辑在持续运行——简单举三个最重要的:
• 垃圾回收(GC)——把零散的有效数据挪到一起,腾出可以整块擦除的空间; • 磨损均衡(Wear Leveling)——让每个存储块轮流干活,别把某一块先累死; • 纠错与读重试(ECC / Read Retry)——当读取结果出现较多错误时,先通过ECC尝试纠正;必要时再调整读取条件重新读取,尽可能把数据恢复出来。
所以这里存在一个视角差:操作系统看到的是"SSD 很忙",但SSD内部真正发生的事情,可能并不是由当前这几笔主机读写直接引起的。Linux 不知道 SSD 在做什么,它只能看到 I/O 请求迟迟没有返回。
四、为什么我会怀疑是数据保持(Data Retention)?
回到这台测试机本身。它有几个比较特殊的条件:这台电脑很久没有开机;重新上电以后出现持续的磁盘活动;主机侧没有明显的大量读写请求;但整体响应严重受影响。这时候,一个可能性进入了我的考虑范围——SSD 是否正在执行与长期数据保存相关的后台维护?
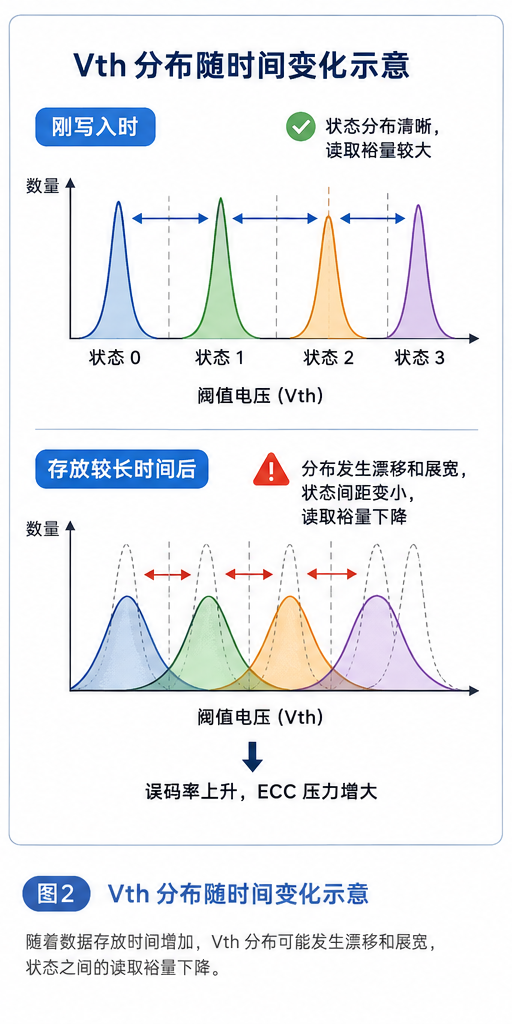
这里要解释一个和机械硬盘完全不同的事实:NAND 闪存保存数据,靠的是每个存储单元里保存的电荷,而这个状态不是永久稳定的。 随着时间推移,电荷会逐渐泄漏,单元的阈值电压(Vth)会发生漂移——原本分得很开的不同电压状态,时间久了可能越来越难区分,读取时的裕量会逐渐受到影响。
可以粗略把它想象成铅笔写在纸上的字:刚写下时边界很清楚,时间久了以后逐渐变得难以辨认。NAND 并不是真的像铅笔一样"褪色",但结果有些类似——原本容易区分的存储状态,随着存放时间增加,读取裕量可能逐渐下降。
五、SSD 长时间不上电,后台可能在做什么?
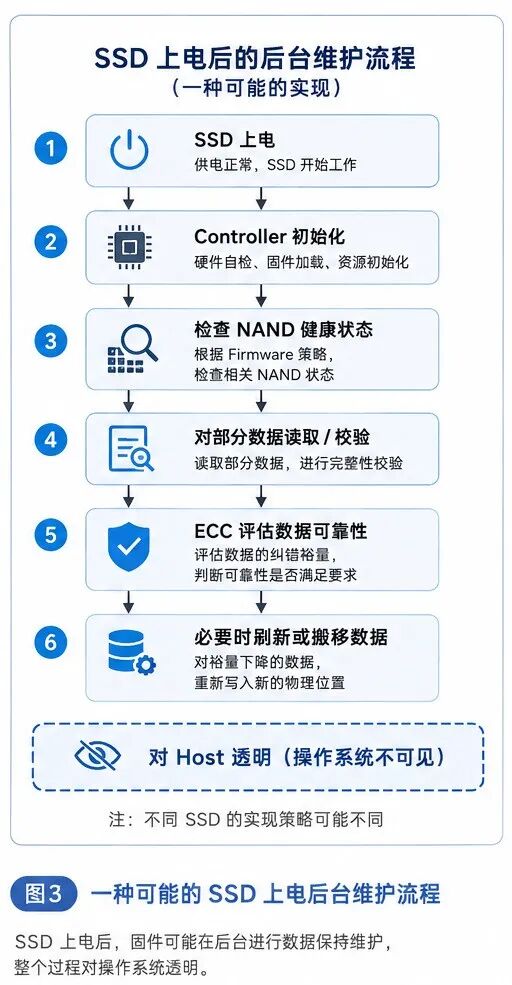
对于操作系统来说,它只能看到"这个磁盘一直很忙"。但 SSD 控制器内部,可能正在执行一个类似这样的流程:
SSD 上电
↓
Controller 初始化
↓
根据 Firmware 策略检查相关 NAND 状态
↓
对部分数据进行读取或校验
↓
ECC 评估数据可靠性
↓
必要时刷新或搬移数据
注意,这只是一种可能的实现思路,并不代表所有 SSD 上电以后都会执行这样一套流程。
为什么这么说?因为不同 SSD 的固件策略差异很大:要不要扫描、什么时候扫描、依据什么条件触发维护——是看擦写次数、温度、存放时间,还是纠错裕量——这些都是各家固件的实现细节,没有统一标准。
这些操作对电脑完全透明。Linux 不知道 SSD 在干什么,它只能看到:I/O 请求没有及时完成。而站在 SSD 的角度:如果固件判断部分数据的可靠性裕量已经下降,就可能把这些数据重新写入新的物理位置——相当于把已经"褪色"的数据状态,重新"描"一遍。 因为 SSD 的目标从来不是"数据暂时写进去了",而是在整个产品生命周期内,持续保证数据可靠。
六、严谨一点:不能仅凭现象下定论
必须强调:仅仅通过 Linux 层面的现象,并不能百分百断定这次一定是数据保持维护在作怪——SSD 内部还有垃圾回收、后台扫描、读干扰管理等其他后台活动,同样可能让主机 I/O 变慢。
但把几个条件放在一起看——长时间没有开机、重新上电、主机侧没有大量读写、SSD 却长时间高负载——数据保持维护,是一个非常合理的怀疑方向。这也是固件工程师排查问题的常态:主机侧的观测手段有限,很多结论只能"高度可能",无法"绝对确定"。如果真要把这次的问题完全坐实,还需要进一步结合 SSD 的内部日志、SMART 信息,甚至固件侧的后台任务状态来确认——主机侧只能定位方向,最终定性还需要设备侧的证据。
七、一次卡顿,两个世界
回顾这次排查的完整链条:wget 下载慢 → 怀疑网络 → 发现远程操作也慢 → 排除网络 → 查内存,排除内存压力 → 查磁盘 I/O,设备很忙但主机请求量不大 → 进一步思考:SSD 控制器内部正在做什么?
这正是固件工程师和普通用户观察问题的区别。普通用户看到的是"电脑卡了",固件工程师会追问:主机下面的那块 SSD,现在到底在忙什么?
以前很多人认为,SSD 就是一块比机械硬盘快的存储设备。但实际上,现代 SSD 更像一台运行在电脑内部的小型计算机——它有自己的控制器、固件、映射表、纠错引擎和一整套 NAND 管理算法。你看到的是打开文件、保存文件、下载文件;它内部在做的是管理 NAND、处理错误、维护可靠性、优化性能。
很多时候电脑出现异常,不一定是操作系统的问题。 在你看不到的地方,那块 SSD 可能正在为了保护你的数据,默默完成自己的工作。
对普通用户来说,这次经历其实也留下了两个很简单的提醒:长期闲置的电脑重新开机后如果异常卡顿,不要一上来就重装系统,可以先看看 CPU、内存和磁盘 I/O 到底是谁出了问题;而真正重要的数据,也不要把可靠性完全寄托在一块长期断电的 SSD 上——备份永远比猜测它还能保存多久更可靠。
— 下一篇预告 —
这篇提到的"电荷会泄漏、数据要维护",引出一个更直接的问题:
《SSD科普三十六:SSD断电一年,里面的数据真的还在吗?》
NAND 里的电荷到底能保存多久?下一篇,我们从 Data Retention 讲起,把这笔"SSD 数据寿命账"算清楚。
👇 评论区聊聊
你有没有遇到过 U 盘或硬盘放久了,文件突然读不出来的情况?当时是怎么处理的?欢迎留言,下一篇我会挑典型的留言来分析。
SSD科普|从Firmware工程师的视角,看看普通用户看不到的SSD内部世界。
谢谢你读我的文章
 支付宝
 微信