前面介绍L2P时,我们讲过,主机看到的是逻辑地址,而数据真正写入SSD时,FTL需要为它分配一个NAND物理地址。
那么,找到一个空闲Page以后,数据是不是直接写进去就可以了?
当然可以。
但“能够写进去”和“高效地写进去”,是两回事。
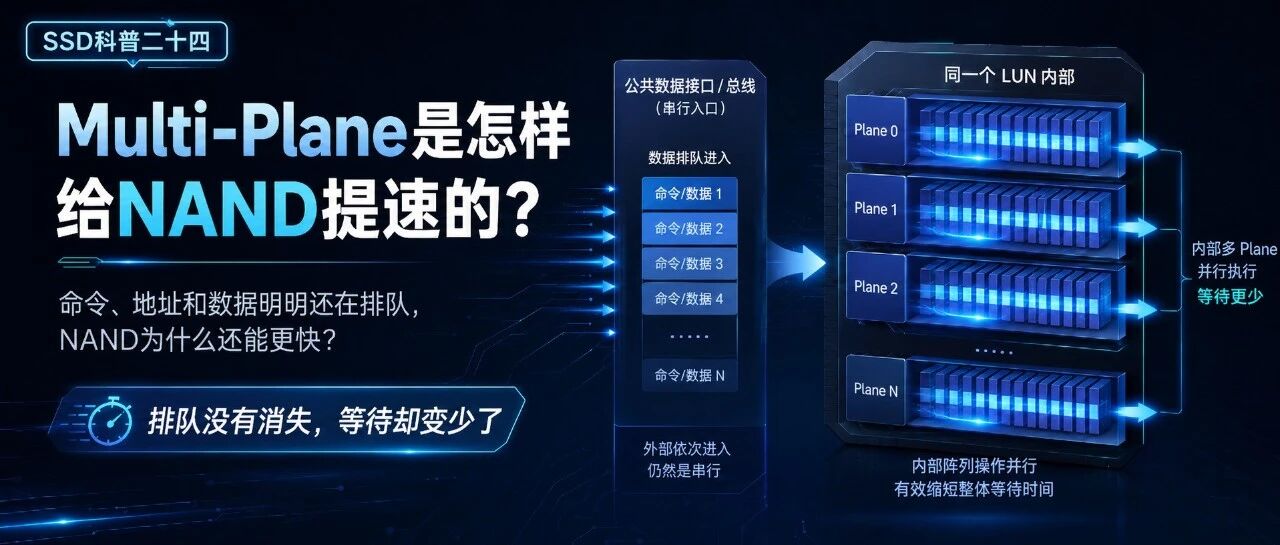
一个LUN内部通常包含多个Plane。
如果分别对这些Plane执行Erase、Program或者Read,最直接的办法是:一个Plane做完,再轮到下一个Plane。
而Multi-Plane可以先依次准备多个Plane,再让它们同时执行内部阵列操作。
乍一看,好像只要增加Plane数量,NAND就能成倍提速。
但事情并没有这么简单。
这些Plane仍然共用NAND接口,命令和地址需要依次发送,Program的数据也要一份一份传进去,Read出来的数据同样要依次传回Controller。
既然外面的数据还在排队,NAND的速度究竟是从哪里提升的?
答案是:
Multi-Plane没有让单个Page写得更快,也没有缩短单个Block的擦除时间。它提升的是多个Plane一起工作时的整体吞吐率。
为了方便说明,本文以一个LUN内部包含四个Plane为例。实际NAND可能包含两个、四个、六个或者其他数量的Plane,具体取决于NAND本身的组织结构。
一、Multi-Plane的“提速”,究竟指什么?
一次NAND操作,大致可以分成两个阶段。
第一个阶段,是通过NAND接口传输命令、地址和数据。
例如Program时,Controller需要先发送Program命令和目标地址,再把一整个Page的数据传入NAND内部寄存器。
Read时,Controller先发送读取地址;等内部读取完成以后,还要把寄存器中的数据传回来。
第二个阶段,是NAND内部真正的阵列操作:
Erase命令完成时间对应tBERS;
Program命令完成时间对应tPROG;
Read命令完成时间对应tR。
Multi-Plane并没有让这些单次物理操作本身变快。
一个Plane原来需要多长时间完成Program,使用Multi-Plane以后,它仍然需要完成自己的Program过程;一个Block原来需要多长时间完成Erase,也不会因为参与Multi-Plane就突然缩短。
Multi-Plane真正改变的是:
原本需要在多个Plane上依次执行的阵列操作,现在可以在同一段时间内发生重叠。
换句话说,Multi-Plane不是让一次操作跑得更快,而是让一次等待中完成更多工作。
外部接口仍然在排队,但NAND内部可以同时开工。
不过,Plane为什么能够同时进行阵列操作,却又不能像独立NAND一样各自执行不同命令?
这就需要先分清LUN和Plane各自承担的角色。
二、Plane可以并行,但LUN才是命令执行和状态管理的基本单位
前面介绍NAND组织结构时,我们讲过:
一个LUN内部包含多个Plane;
每个Plane中包含大量Block;
每个Block又由许多Page组成。
Plane虽然拥有自己的NAND阵列,以及与阵列操作相关的内部资源,但它并不是一个可以完全独立接收命令、进入Busy并返回状态的小型NAND。
更准确地说:
Plane是内部阵列并行的单位,LUN才是能够独立执行阵列操作、进入Busy并被查询状态的基本单位。
当Controller向一个LUN发出普通的Read、Program或者Erase操作以后,这个LUN就会进入Busy状态。
此时,不能因为Plane 1暂时没有参与操作,就随意向Plane 1插入另一条无关的阵列命令。
例如,不能让:
Plane 0正在Program,Plane 1同时独立Erase。
从Controller的角度看,不是Plane 0单独进入了一个完全独立的工作状态,而是这个LUN正在执行一项阵列操作。
因此,同一次Multi-Plane操作中的多个Plane必须执行相同类型的操作:
要么一起Erase;
要么一起Program;
要么一起Read。
Multi-Plane并没有把多个Plane变成多个独立的LUN。
它只是允许Controller在同一个LUN的命令序列中,依次准备多个Plane,最后让它们共同执行同一种阵列操作。
这里所说的“不能被打断”,是指不能在Busy期间随意插入另一条无关的普通阵列命令。
Read Status只是查询状态;Suspend是NAND明确支持的受控暂停;Reset则可能直接终止当前操作。它们都不代表另一个Plane可以像独立LUN一样自由执行命令。
既然LUN统一管理命令和状态,Multi-Plane又是怎样把多个Plane组织进同一轮操作中的?
三、Multi-Plane的共同流程:依次准备,统一触发
虽然Erase、Program和Read处理的对象不同,但它们的Multi-Plane过程有一个共同逻辑:
Controller先依次准备不同Plane,最后再发送最终确认,让多个Plane同时执行内部阵列操作。
这里的“依次准备”非常重要。
多个Plane仍然共用NAND接口,所以命令和地址不能凭空同时进入多个Plane;Program的数据也仍然需要一份一份传输。
在很多NAND中,前面几个Plane准备完成后,Controller会发送中间确认命令。中间确认并不会立即触发完整的Erase、Program或者Read,而是把当前Plane的信息加入这一次Multi-Plane操作。
此后,LUN可能会经历一段较短的Busy时间,用来完成地址、数据的锁存以及内部准备。
等LUN重新Ready以后,Controller再继续准备下一个Plane。
直到最后一个Plane也准备完成,最终确认命令才会触发真正耗时较长的内部阵列操作。
因此,Multi-Plane并不是简单地把几条普通命令同时发送出去,而是一套完整的命令序列:
依次准备多个Plane → 中间进行短暂的内部锁存和准备 → 最终确认 → 多个Plane同时执行阵列操作
真正被重叠起来的,是最后的tBERS、tPROG或者tR,而不是所有步骤。
理解这个共同流程后,下面就可以分别来看Erase、Program和Read。
四、Multi-Plane Erase:Block地址依次准备,擦除过程同时进行
NAND不能直接覆盖写入。当一个Block准备进入新一轮使用时,需要先执行Erase,将其中的Cell恢复到擦除态。
Erase的最小单位是Block。
假设现在需要擦除四个Plane中的四个Block:
Plane 0中的Block A;
Plane 1中的Block B;
Plane 2中的Block C;
Plane 3中的Block D。
如果使用普通单Plane Erase,就需要等待Plane 0完成以后,再去擦除Plane 1中的Block,随后继续处理Plane 2和Plane 3。
四段tBERS只能前后排列。
Multi-Plane Erase则会先依次发送不同Plane的Block地址。
前面几个Block地址通过中间确认加入本次操作,但不会立即开始完整的Erase。
等最后一个Block地址也准备完成后,最终确认命令触发内部擦除:
依次准备多个Block地址 → 发送最终确认 → 多个Plane分别擦除自己的Block → 多段tBERS发生重叠
需要注意,Multi-Plane Erase并没有把多个Block合并成一个更大的Block。
它们仍然属于不同Plane,也仍然分别完成各自的Erase,只是这些擦除过程发生在同一段时间内。
如图所示:
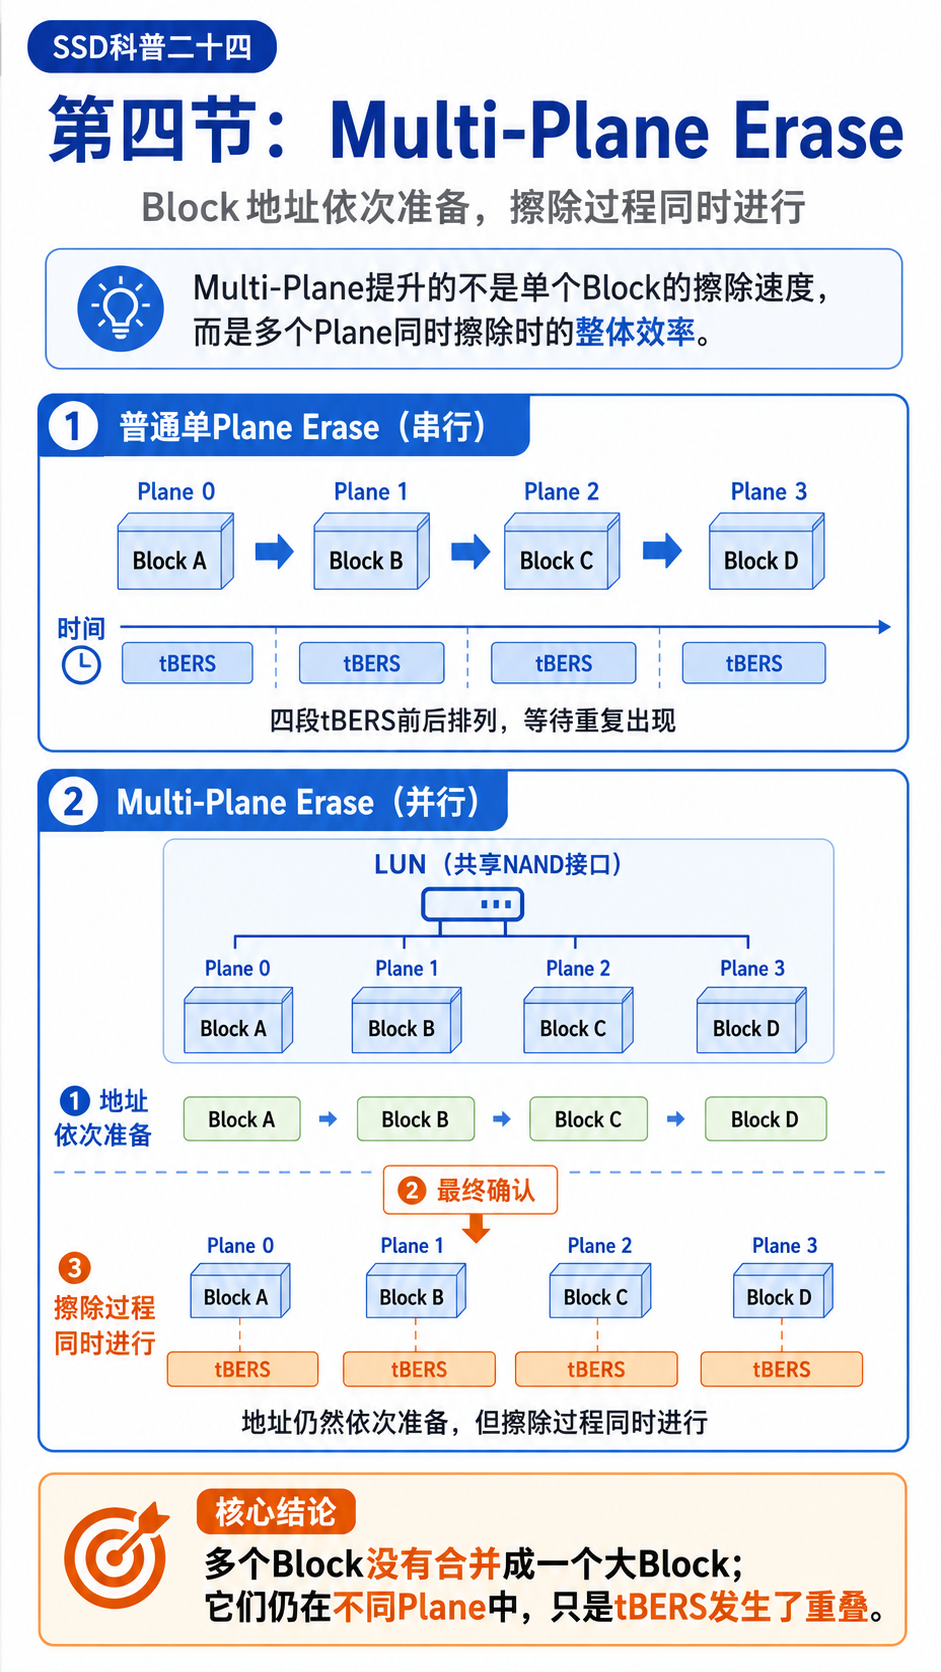
Erase没有Page数据需要输入或输出,所以它的Multi-Plane过程比较直观:
地址仍然依次准备,但耗时较长的擦除过程可以同时进行。
Block恢复到擦除态以后,接下来才能向其中Program数据。而Program比Erase多了一步:每个Page的数据还要先通过公共接口传入NAND。
这也是Multi-Plane Program最容易被误解的地方。
五、Multi-Plane Program:数据依次传入,tPROG同时进行
一次Page Program并不是把数据传入NAND以后就结束了。
它可以分成两个过程。
第一个过程,是数据输入。
Controller发送Program命令和目标地址,再通过NAND接口把Page数据传入内部寄存器。
第二个过程,才是真正的内部Program。
NAND通过多轮编程脉冲和Verify,逐步改变Cell的阈值电压,直到需要编程的Cell达到目标状态。
这一段内部阵列操作通常用tPROG表示。
因此:
数据已经进入NAND内部寄存器,并不代表它已经写入了NAND Cell。
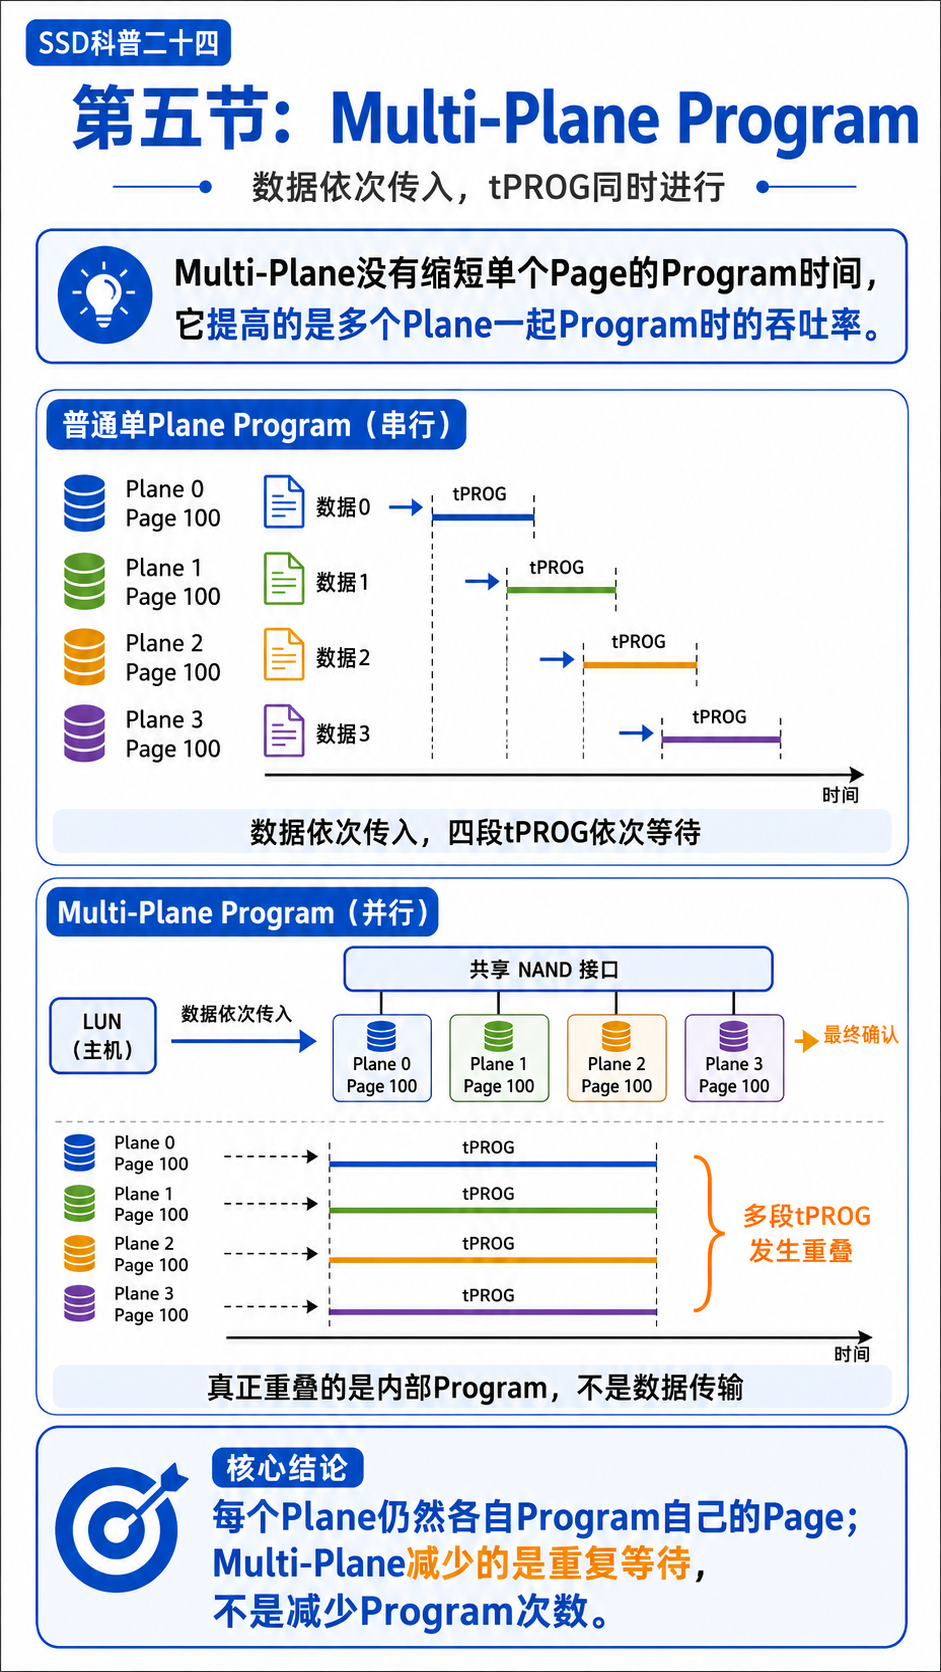
如果分别向四个Plane写入一个Page,普通单Plane Program需要:
先向Plane 0传入数据并等待tPROG;
等LUN重新Ready以后,再准备Plane 1;
随后依次处理Plane 2和Plane 3。
Multi-Plane Program则会先为Plane 0发送地址和数据。
Plane 0准备完成后,通过中间确认把这份数据保留在对应的内部寄存器中,但不立即开始完整的tPROG。
接下来,Controller再依次为Plane 1、Plane 2和Plane 3传入各自的数据。
等最后一个Plane也准备完成以后,最终确认命令才会触发内部Program:
多份Page数据依次传入 → 最终确认 → 多个Plane分别Program自己的Page → 多段tPROG发生重叠
所以,Multi-Plane Program并没有减少Program次数。
每个Plane仍然需要对自己的Page执行Program,四个Plane也仍然分别完成四次物理Program。
改变的只是它们在时间上的排列方式:
原本前后串行的多段tPROG,现在发生在同一段时间内。
Multi-Plane省掉的不是多份数据的传输时间,而是多个Plane依次执行内部Program带来的重复等待。
这也解释了为什么四个Plane并不意味着写入性能一定提高四倍。
四份Page数据仍然需要依次传入;中间确认和tDBSY仍然存在;不同Plane的Program时间也不一定完全相同。
整个LUN通常需要等待参与操作的Plane全部完成以后才会恢复Ready,因此最终时间还会受到其中最慢Plane的影响。
更准确地说:
Multi-Plane提高的是批量Program的吞吐率,而不是让单个Page的tPROG缩短到原来的四分之一。
如图所示:
Program完成以后,再来看读取数据时会发生什么。
六、Multi-Plane Read:阵列同时读取,数据依次输出
普通Page Read同样可以分成两个阶段。
第一个阶段,是内部阵列读取。
NAND根据地址选中对应Page,对Cell状态进行感应和判断,再把读取结果放入内部寄存器。
这一段时间通常用tR表示。
第二个阶段,是数据输出。
Controller通过NAND接口,将寄存器中的数据传回Controller。
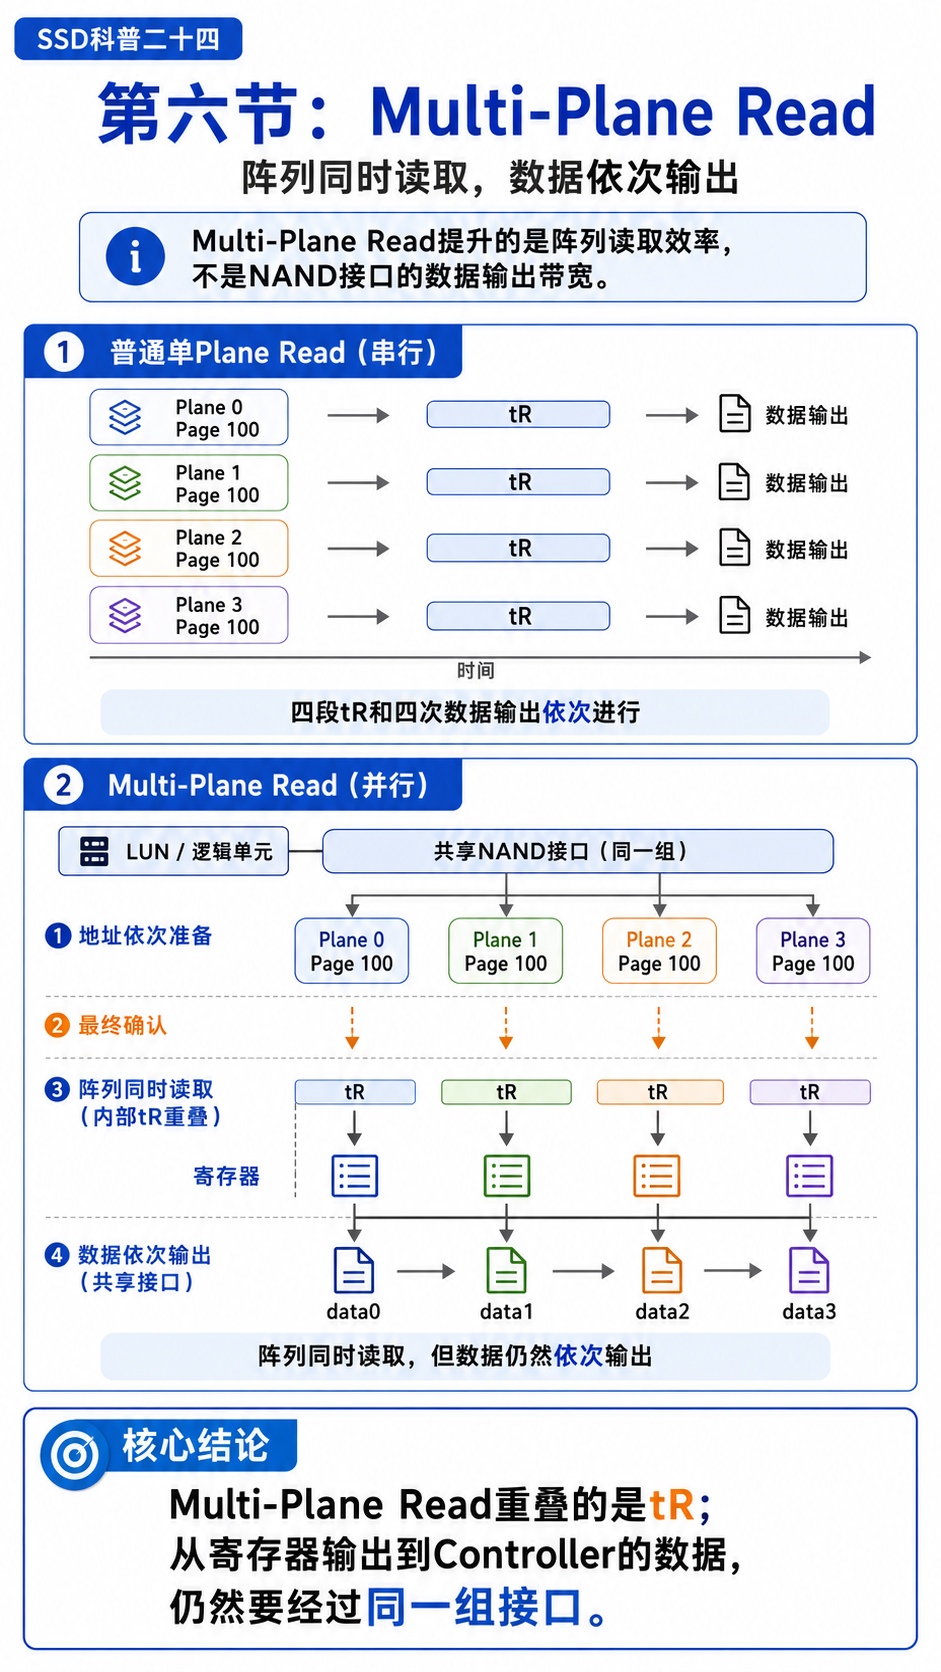
如果使用普通单Plane Read,就需要:
Plane 0完成内部Read并输出数据;
再读取Plane 1;
随后依次处理Plane 2和Plane 3。
每个Plane的tR只能前后等待。
Multi-Plane Read则先依次发送多个Plane的读取地址。等最后一个地址也准备完成后,最终确认命令触发内部读取。
多个Plane同时对各自选中的Page进行感应,并把结果分别放入对应的内部寄存器:
多个Page地址依次准备 → 多个Plane同时执行内部Read → 多段tR发生重叠
但内部Read完成,并不代表所有数据已经同时传回Controller。
这些Plane仍然共用NAND接口,因此Controller还要选择不同Plane的寄存器,将数据一份一份输出。
整个过程可以概括成:
地址依次准备,阵列同时读取,数据依次输出。
所以,Multi-Plane Read提高的是从NAND阵列读取到内部寄存器这一阶段的并行度,而不是提高NAND接口本身的数据输出带宽。
如图所示:
到这里,三种Multi-Plane操作的共同点已经很清楚了:
Erase重叠tBERS,Program重叠tPROG,Read重叠tR。
不过,Multi-Plane并不是NAND中唯一的提速方式。它与前面介绍过的Cache操作,以及多个LUN之间的并行,又有什么区别?
七、Multi-Plane、Cache和Multi-LUN不是同一种并行
Cache操作主要利用不同寄存器形成流水线,参考SSD科普五:Nand组织结构中的Cache。
例如,当上一份数据正在执行内部Program时,Controller可以提前把下一份数据传入Cache Register,让数据传输和内部Program尽量重叠。
它解决的是:
前后两轮操作之间,怎样形成流水线。
Multi-Plane利用的则是同一个LUN内部,不同Plane之间的阵列并行。
它解决的是:
同一轮操作中,怎样让多个Plane同时执行阵列操作。
两种能力还可以组合起来,形成Multi-Plane Cache Program或者Multi-Plane Cache Read。
Multi-LUN则属于更高一层的并行。
不同LUN本身就是能够独立进入Busy、执行阵列操作并查询状态的单位。
当LUN 0正在Program时,Controller可以安排LUN 1执行另一项操作,而不必等LUN 0先完成。
所以:
Cache利用寄存器流水;
Multi-Plane利用一个LUN内部的Plane并行;
Multi-LUN利用多个独立LUN之间的并行。
但即使NAND支持Multi-Plane,Controller也不能随便从不同Plane中挑选几个空闲Page,然后让它们一起工作。
八、不是几个空闲Page就能组成Multi-Plane
一次合法的Multi-Plane操作,通常需要满足一些基本条件。
首先,参与操作的地址必须属于同一个LUN。如果地址来自不同LUN,就已经属于Multi-LUN并行,而不是Multi-Plane。
其次,这些地址需要来自不同Plane。同一个Plane不能在一次Multi-Plane操作中,同时对两个不同位置执行阵列操作。
再次,不同Plane中的Page位置通常需要相互对应。
例如:
Plane 0:Block A中的Page 100;
Plane 1:Block B中的Page 100;
Plane 2:Block C中的Page 100;
Plane 3:Block D中的Page 100。
这里的Block A、B、C和D不一定拥有相同的Block编号。
如果NAND支持Unaligned Multi-Plane,不同Plane可以选择不同编号的Block,但它们在各自Block中的Page Offset通常仍然需要相同。
对于TLC和QLC,还要继续考虑Page Type、Program阶段和写入顺序等要求。
不同NAND支持的Plane组合和地址顺序也可能不同。有的支持任意合法Plane组合,有的要求按照固定Plane顺序准备,还有的只允许使用特定的Plane组合。
所以,Multi-Plane并不是一套脱离具体NAND限制的通用地址拼接方式。
Controller必须了解当前NAND的Plane数量、地址结构和合法操作规则。
而这些限制,最终都会继续传递到FTL。
九、为什么Multi-Plane最终会影响FTL?
前面介绍L2P时,我们主要关注的是:
一份逻辑数据当前对应哪个NAND物理地址。
但FTL真正分配物理地址时,不能只判断这里是否还有一个空闲Page。
如果希望使用Multi-Plane,FTL还要判断:
能否在同一个LUN的不同Plane中,找到Page位置相互对应、Program阶段一致、Plane组合合法的一组物理地址?
偶尔凑出一次合法的Multi-Plane操作并不困难。
真正困难的是,在SSD长期运行过程中,不同Plane会遇到不同的坏块、Program Fail、Erase Fail和垃圾回收,它们的物理空间状态也会逐渐出现差异。
除此之外,Multi-Plane操作也不能天然被当成一个原子事务。
假设一次Multi-Plane Program最终报告失败,可能是所有Plane都失败了,也可能只有其中一个Plane失败,而其他Plane已经Program成功。
FTL不仅要知道这次操作失败了,还要继续考虑:
哪些Plane已经成功;
哪个Plane发生了Program Fail或者Erase Fail;
失败的数据应该写到哪里;
成功写入的Page应该如何处理;
L2P应该在什么时间更新;
相关Block是否需要进入坏块处理。
所以,Multi-Plane不仅要求FTL组织出满足条件的一组物理地址,还要求它能够处理其中某个Plane失败、其他Plane已经成功的情况。
这意味着,FTL不能永远把每一个Block当成完全孤立的资源来管理。
它需要在不同Plane中的Block之间,建立更高一层的组织关系,让它们在擦除、写入、读取和异常处理时保持协调。
这也是接下来理解SPB之前,必须先弄清楚Multi-Plane的原因。
十、总结
Multi-Plane没有让公共接口变成多路并行,也没有缩短单个Page或者Block的物理操作时间。
它真正做的,是在同一个LUN内部依次准备多个Plane,再让这些Plane的内部阵列操作发生重叠:
Erase重叠的是tBERS;
Program重叠的是tPROG;
Read重叠的是tR。
命令、地址和数据仍然需要排队,但在同一段等待时间里,NAND内部完成了更多工作。
这才是Multi-Plane给NAND提速的真正原因。
只是,要让这种并行能力在SSD长期运行过程中持续发挥作用,FTL就不能再把每个Block完全孤立地管理。
至于这些Block究竟应该怎样组织,就是接下来需要解决的问题。
谢谢你看我的文章
 Alipay
 Wechat