前面几篇,我们开始从 NAND 逐渐走进 SSD Firmware。
上一篇介绍 FTL 时提到,FTL 最重要的职责,是完成数据的写入和读取。
但这里还有一个问题没有展开:
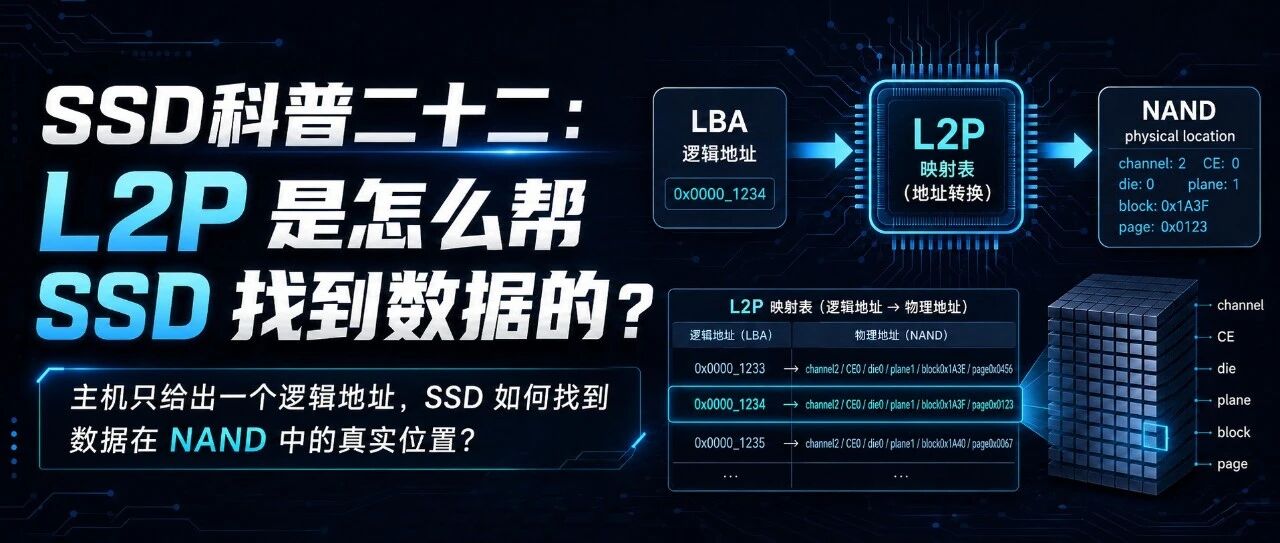
主机发给 SSD 的只是一个逻辑地址,SSD 怎么知道这份数据究竟存放在 NAND 的哪个位置?
这个问题的答案,就是 L2P。
L2P 的全称是 Logical-to-Physical Mapping,也就是从逻辑地址到物理地址的映射。
从表面上看,它只是一张地址表。
但几乎每一次用户读写、数据搬迁、垃圾回收和坏块处理,背后都离不开这张表。
一、主机只知道 LBA
主机访问 SSD 时,并不知道 SSD 内部有多少个 Channel、多少个 CE、多少个 Die,也不知道某一份数据具体写进了哪个 Plane、Block 和 Page。
主机只会告诉 SSD:
请读取某个 LBA。
请把这段数据写入某个 LBA。
LBA 的全称是 Logical Block Address,也就是主机看到的逻辑块地址。
但是在 NAND 内部,并不存在一个天然叫作“LBA 1000”的物理位置。
FTL 必须把主机提供的逻辑地址,转换成 NAND 中真正存放数据的位置。
这个物理位置通常可以抽象成 PPA,也就是 Physical Page Address。
因此,一次最基本的读取过程可以表示为:
主机给出 LBA
↓
Firmware 查询 L2P
↓
得到 PPA
↓
读取 NAND
这就是 L2P 最基本的作用。
它连接了主机看到的逻辑地址,以及 SSD 内部真正使用的物理地址。
二、LBA、LPN 和 PPA 分别是什么?
严格来说,主机使用的逻辑地址和 Firmware 内部使用的逻辑页编号,是两个不同层面的概念。
主机发出读写命令时,使用的是 LBA。
Firmware 管理 L2P 时,则会按照自己的映射粒度,把逻辑地址空间划分成一个个逻辑单元。
这些逻辑单元的编号,通常称为 LPN,也就是 Logical Page Number,逻辑页号。
为了避免引入 Partial Write、Read-Modify-Write 等额外问题,本文采用一个简化模型:
一个 LBA 的大小为 4 KiB。 Firmware 的 L2P 映射粒度也是 4 KiB。
在这个假设下,一个 LBA 正好对应一个内部逻辑单元。
例如:
LBA 1000 对应 LPN 1000。
所以从 Firmware 的严格定义来看,L2P 保存的是:
LPN → PPA
不过,在本文设定的 4 KiB LBA 和 4 KiB 映射粒度下,LBA 与 LPN 是一一对应的。
为了避免后文反复切换名词,在不需要特别区分时,仍然直接使用 LBA 表示逻辑地址。
三、一个 LPN 不一定对应一整个 NAND Page
这里还有一个很容易混淆的问题:
L2P 的映射粒度,并不一定等于 NAND 的物理 Page 大小。
以本文讨论的 Firmware 为例:
L2P 的映射粒度为 4 KiB。
一个 NAND Page 的数据区大小为 16 KiB。
因此,一个 16 KiB NAND Page 可以承载 4 个 4 KiB 的逻辑数据单元。
例如:
LPN 1000 → Page A 内第 0 个 4 KiB 单元
LPN 1001 → Page A 内第 1 个 4 KiB 单元
LPN 1002 → Page A 内第 2 个 4 KiB 单元
LPN 1003 → Page A 内第 3 个 4 KiB 单元
所以,L2P 查询出来的物理地址,最终要能够定位到数据所在的 Channel、CE、Die、Plane、Block、Page,以及 Page 内部的具体位置。
为了方便理解,后文仍然使用 PPA A、PPA B、PPA C 这样的简化写法。
四、L2P 本质上是一张索引表
最简单的 L2P,可以把它理解成一个很大的数组。
数组的下标是逻辑页号,数组中保存的值是物理地址。
例如:
LPN 1000 → PPA A
LPN 1001 → PPA B
LPN 1002 → PPA C
当主机读取 LBA 1001 时,Firmware 先得到对应的 LPN 1001,然后查询 L2P,找到 PPA B,最后向 NAND 下发读取命令。
从读取角度来看,L2P 很像一本通讯录:
主机提供名字,L2P 给出地址。
但它和普通通讯录又有一个很大的区别。
普通人的家庭住址可能几年都不会发生变化,而同一个 LBA 在 NAND 中的物理位置,却可能不断改变。
五、为什么同一个 LBA 的物理位置会变化?
这是理解 L2P 的关键。
NAND 不能像普通内存那样,直接对已经写入的位置进行覆盖修改。
假设当前的映射关系是:
LBA 1000 → PPA A
后来,主机再次向 LBA 1000 写入新数据。
SSD 通常不会直接修改 PPA A 中的旧数据,而是从空闲空间中分配一个新的物理位置,例如 PPA B,把新数据写进去。
新数据写入成功后,L2P 更新为:
LBA 1000 → PPA B
原来的 PPA A 不再保存最新版本的数据,因此在逻辑意义上变成 Invalid。
以后垃圾回收搬迁数据时,PPA B 中的有效数据还可能被复制到 PPA C。
此时映射又会变成:
LBA 1000 → PPA C
所以,主机看到的 LBA 一直没有变化,但数据在 NAND 中的真实位置可能已经经历了:
PPA A → PPA B → PPA C
L2P 的职责就是:
无论数据在 NAND 中搬过多少次家,主机再次访问这个 LBA 时,Firmware 都必须找到它当前最新的位置。
六、一次读写怎样查询和更新 L2P?
假设主机要求读取 LBA 1000。
在本文的设定下,LBA 1000 对应内部的 LPN 1000。
Firmware 首先查询 L2P:
LPN 1000 → PPA C
接下来,Firmware 根据 PPA 中的信息,确定数据所在的 NAND 物理位置,并向 NAND 下发读取命令。
整个 Read Path 可以简化为:
主机给出 LBA
↓
Firmware 得到对应的 LPN
↓
查询 L2P
↓
得到最新 PPA
↓
向 NAND 下发 Read
↓
数据返回主机
写入时,Firmware 不仅要查询地址,还要修改映射。
假设当前映射为:
LBA 1000 → PPA A
主机现在重新写入 LBA 1000。
FTL 首先分配新的物理位置 PPA B,然后把数据写入 PPA B。
当新数据写入成功后,L2P 更新为:
LBA 1000 → PPA B
与此同时,旧位置 PPA A 被视为 Invalid。
这个过程可以简化为:
分配新的物理位置
↓
把数据写入新位置
↓
更新 L2P
↓
旧位置变成 Invalid
这里有一个非常重要的顺序问题。
如果 L2P 已经指向 PPA B,但 PPA B 实际上还没有写入成功,那么下一次读取时,就可能读到不存在或者不完整的数据。
因此,在真实 Firmware 中,数据写入、L2P 更新和元数据持久化之间,需要严格保证一致性。
另外,旧位置变成 Invalid,并不代表 Firmware 一定要立刻重新修改那个 NAND Page。
实际设计中,Firmware 通常会通过 Valid Bitmap、Page Metadata 或其他管理信息,记录旧位置已经失效。
七、哪些后台操作会修改 L2P?
除了主机覆盖写,还有很多后台操作会改变 L2P。
垃圾回收选择一个 Victim Block 后,需要把其中仍然有效的数据搬到新的 Block。
只要数据的物理位置发生变化,对应的 L2P 就必须同步更新。
否则,旧 Block 被擦除以后,Firmware 仍然按照旧映射读取,就会访问到已经不存在的数据。
如果某个位置在 Program 过程中失败,Firmware 可能会把数据重新写入其他健康位置。新位置确定后,L2P 也要指向新的位置。
某个 Block 被判断为不再可靠时,其中仍然有效的数据也可能需要被转移。只要发生数据搬迁,L2P 就必须跟着更新。
当文件被删除后,操作系统还可以通过 TRIM 或 Deallocate 告诉 SSD:
这些逻辑地址中的数据已经不再需要保留。
Firmware 会把这些逻辑地址标记为已经 Deallocate。以后垃圾回收时,对应的旧数据不再需要继续搬迁,从而减少额外的 NAND 写入。
所以,L2P 并不是一张静止不动的表。
它会随着用户写入和后台数据管理不断发生变化。
八、为什么 GC 仅有 L2P 还不够?
L2P 是一张正向映射表:
给出 LPN,找到 PPA。
它非常适合 Read Path。
但垃圾回收面对的是一个物理 Victim Block。
GC 需要知道:
这个物理位置中的数据是否仍然有效?
如果有效,它属于哪个 LPN?
搬迁完成后,应该修改哪一条 L2P Entry?
仅仅依靠 L2P,并不方便从一个 PPA 反推出它属于哪个 LPN。
因此,实际 Firmware 除了维护 L2P,通常还需要借助其他信息,例如 OOB 或 Spare 中保存的逻辑地址信息、Valid Page Bitmap、Page Metadata,以及 Block 或 Page 状态表。
这样,GC 在搬迁有效数据时,才能知道这份数据属于哪个 LPN,并更新对应的 L2P Entry。
可以把两者简单理解为:
L2P 负责从逻辑地址找到物理位置。 GC 还需要反向信息,从物理位置认出它属于哪个逻辑地址。
九、完整 L2P 到底有多大?
Page-level Mapping 非常灵活,但它有一个很现实的问题:需要占用大量 DDR。
假设一块 SSD需要管理 1 TiB 的逻辑地址空间,L2P 的映射粒度为 4 KiB。
需要管理的逻辑页数量为:
1 TiB ÷ 4 KiB = 268,435,456
也就是说,大约需要 2.68 亿条 L2P Entry。
假设每一个 L2P Entry 占用 4 Byte,那么完整 L2P 所需要的空间为:
268,435,456 × 4 Byte = 1,073,741,824 Byte = 1 GiB
换句话说:
在4 KiB 映射粒度、每条 L2P Entry 占用4 Byte 的情况下,每管理 1 TiB 逻辑地址空间,大约需要 1 GiB DDR 保存完整 L2P。
按照同样的计算方式:
8 TiB 逻辑地址空间,大约需要 8 GiB L2P。
16 TiB 逻辑地址空间,大约需要 16 GiB L2P。
32 TiB 逻辑地址空间,大约需要 32 GiB L2P。
而这还只是最基础的逻辑地址到物理地址映射。
SSD 的 DDR 还需要保存缓存、队列、Block 状态、错误信息,以及各种 Firmware 运行数据。
因此,不可能把全部 DDR 都留给 L2P。
这也是为什么 SSD 容量不断增大以后,Mapping Table 会逐渐成为 Firmware 设计中不可忽视的一项资源。
十、为什么地址翻译要尽量在 DDR 中完成?
对于高性能 SSD 来说,最理想的读取过程是:
LBA
↓
在 DDR 中查询 L2P
↓
得到 PPA
↓
直接读取用户数据
DDR 的访问速度远快于 NAND。
只要正常 Read Path 所需要的映射能够在 DDR 中查询到,Firmware 就可以快速确定用户数据的物理位置,然后直接向 NAND 下发读取命令。
但如果目标映射不在 DDR 中,Firmware 就可能需要先从 NAND 读取 Mapping 信息,再读取真正的用户数据。
此时读取过程会变成:
先读取 Mapping
↓
获得数据物理地址
↓
再读取用户数据
这两次 NAND Read 之间存在严格的前后依赖。
在拿到 Mapping 之前,Firmware 甚至不知道真正的数据应该去哪里读取。
额外的 Mapping Read 不仅会增加单次读取延迟,还会和正常用户 IO 争抢 NAND 资源。
在高并发情况下,它还可能影响随机读取性能、高 Queue Depth 下的吞吐,以及 P99、P999 尾延迟。
因此,高性能企业级 SSD 通常会尽量让正常 Read Path 的地址翻译在 DDR 中完成。
至于 DDR 中保存的是完整 L2P、压缩后的 L2P,还是主要工作集,则取决于容量、成本和具体架构。
十一、L2P 放在 DDR,掉电以后怎么办?
DDR 是易失性存储。
SSD 一旦掉电,DDR 中保存的 L2P 就会消失。
但 NAND 中的用户数据并没有消失。
这时就会出现一个严重问题:
数据还在,但 Firmware 已经不知道每一个 LBA 对应的数据究竟存放在哪里。
因此,L2P 常驻 DDR,解决的只是运行时快速查询的问题。
SSD 还必须在非易失介质中,保存足以恢复 L2P 的信息。
可以把两者简单理解为:
DDR 中的 L2P:负责运行时快速查询和更新。 NAND 中的 Mapping 元数据:负责掉电后的恢复。
Firmware 可以通过 Checkpoint、更新日志或其他元数据机制,记录可以恢复 L2P 的信息。一般叫SnapShot。
SSD 再次上电时,根据这些持久化信息,重新在 DDR 中恢复当前有效的 L2P。
真正困难的地方在于:
用户数据和 L2P 更新,是两份彼此关联、却不一定写在同一个物理位置的信息。
于是就会出现一系列问题:
数据已经写成功,但新映射还没有持久化,突然掉电怎么办?
新映射已经记录,但数据没有写成功,应该相信哪一个位置?
GC 搬迁进行到一半时掉电,旧位置和新位置谁才是有效数据?
所以,L2P 管理真正困难的地方,并不只是查询一张表。
Firmware 还必须保证:
NAND 中的数据可以不断移动,但无论正常运行还是异常掉电,这本账都不能记错。
十二、如果完整 L2P 放不进 DDR 呢?
在 4 KiB 映射粒度、每条 L2P Entry 占用 4 Byte 的情况下,每管理 1 TiB 逻辑地址空间,就需要大约 1 GiB DDR 来保存完整 L2P。
随着 SSD 容量不断增大,完整 L2P 对 DDR 的需求也会越来越高。
那么问题来了:
如果一块 SSD 没有足够的 DDR,无法把完整 L2P 全部放进内存,Firmware 还能怎样完成地址翻译?
一种经典思路,是把完整 L2P 拆成很多 Mapping Page,保存到 NAND 中,内存只缓存当前正在使用的部分映射。
但这样一来,又会产生一连串新的问题:
内存中的映射没有命中时,怎样从 NAND 中找到它?
保存映射的 Mapping Page 自己会不会移动?
Mapping 更新后怎样写回 NAND?
为什么一次用户读取可能变成两次 NAND Read?
这种方案为什么节省了内存,却可能影响随机读取和尾延迟?
下一篇,我们来详细拆解一种经典的按需映射方案:
DFTL:当完整 L2P 放不进内存,SSD 怎样从 NAND 中查找映射?
我们会从 CMT、GTD 和 Translation Page 开始,完整走一遍 Mapping Hit、Mapping Miss、Dirty Entry 淘汰和 Mapping Page 搬迁的过程。
由于这部分内容涉及完整的论文结构、地址计算和流程推演,篇幅会比较长,下一篇将以付费长文的形式发布。
谢谢你看我的文章 。
 Alipay
 Wechat