上一篇我们讲到,SSD并不是把几颗NAND焊在电路板上,就可以直接拿来存数据。
NAND只提供了最底层的存储能力。
它能保存电荷,也能通过阈值电压表示数据。但它不知道什么是文件,不认识主机发来的LBA,也不知道一份旧数据失效以后应该如何回收空间。
真正把这些NAND组织起来,让它们表现得像一块普通硬盘的,是Controller,以及运行在Controller上的Firmware。
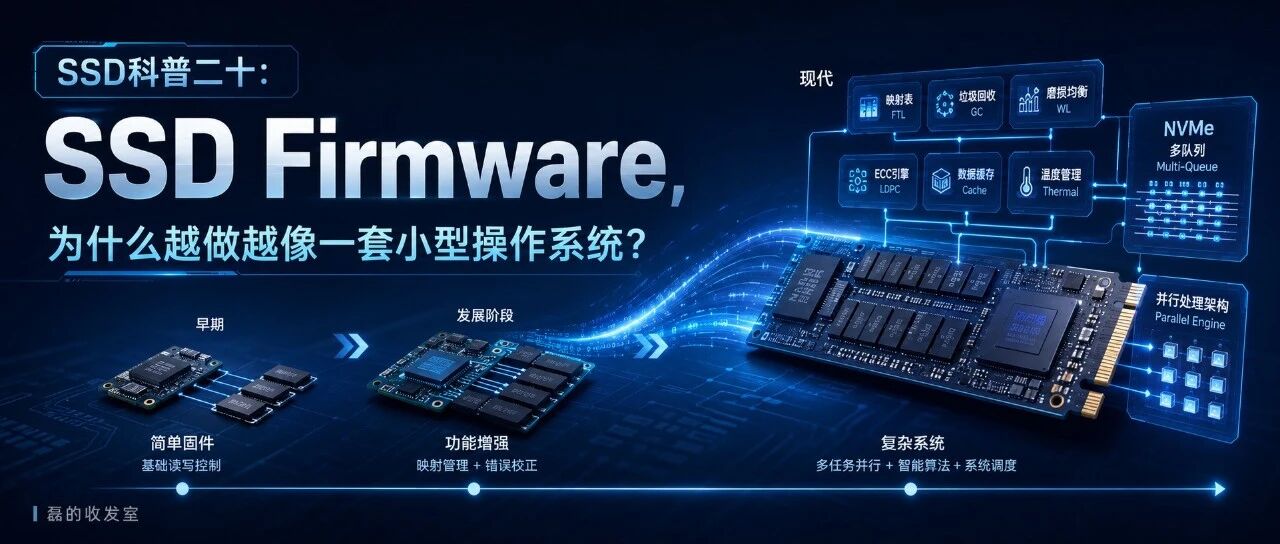
不过,SSD Firmware并不是一开始就像今天这样复杂。
它最初只需要接收主机命令、控制底层存储器完成读写,后来却逐渐加入了地址映射、垃圾回收、磨损均衡、错误恢复、掉电保护、并发调度、温度与功耗管理。
今天的SSD Firmware,甚至已经有点像一套运行在Controller内部的小型操作系统。
为什么会变成这样?
答案并不是工程师喜欢把事情做复杂,而是因为SSD发展过程中,每解决一个问题,往往又会暴露出下一个问题。
一、最早的Firmware,只需要负责“传话”
早在20世纪70年代末,就已经出现了使用半导体存储器构成的固态存储设备。
不过,那些早期设备和今天基于NAND的SSD并不是同一种东西。其中一些使用DRAM或其他存储介质,甚至需要电池维持数据。
当时的Firmware功能比较简单。
主机发来一条读取或者写入命令,Firmware识别命令,再把它转换成底层存储器能够执行的操作。除此之外,再提供一些基本的错误检测与纠正能力,保证数据能够被正确保存和读出。[1]
此时的Firmware,更接近一个翻译员:
主机告诉设备想做什么,Firmware再告诉底层硬件应该怎么做。
如果底层存储器可以像普通内存一样直接修改,那么这套模式并没有太大问题。
但NAND Flash成为主要存储介质以后,情况发生了变化。
因为NAND有一个非常麻烦的限制:已经写过的地方,不能直接覆盖。
二、NAND不能覆盖写,Firmware第一次成为核心
假设主机已经把一份数据写入LBA 1000。
后来,这份数据发生了修改。对于主机来说,它只是再次向LBA 1000写入新内容。
但Firmware不能直接找到原来的NAND Page,把里面的数据改掉。
它只能寻找一张已经擦除的空闲Page,把新数据写到新位置,然后将旧位置标记为无效。
于是,主机看到的地址没有改变,数据实际所在的物理位置却已经发生了变化:
第一次写入:LBA 1000 → 物理Page A 更新以后:LBA 1000 → 物理Page B
这就产生了一个以前不存在的问题:
SSD必须记住,每一个逻辑地址现在究竟对应哪一个物理位置。
于是,Flash Translation Layer,也就是FTL,逐渐成为Firmware中最核心的组成部分。
FTL在主机与NAND之间建立了一层地址转换。主机仍然按照磁盘的方式使用连续的逻辑地址,Firmware则在内部维护逻辑地址到物理地址的映射关系。[2]
这套机制隐藏了NAND不能覆盖写的限制。
从主机的角度看,LBA 1000似乎一直没有变化;但在SSD内部,同一份数据可能已经被搬迁了很多次。
也正是从这里开始,Firmware不再只是传递命令。
它开始拥有一套自己的内部状态,并且必须保证这套状态始终正确。
但问题很快又来了。
建立一张映射表并不困难,困难的是:当SSD容量越来越大时,这张表应该放在哪里?
三、映射越精细,Firmware需要的内存就越多
最简单的办法,是以Block为单位建立映射关系。
一个逻辑Block对应一个物理Block。这样映射表很小,查询也比较简单。
但NAND的写入单位通常是Page,擦除单位却是Block。
假如主机只修改Block中的一个4KB Page,Block级映射可能需要把整个Block中的其他有效数据一起搬走,再重新组织成一个新的Block。
为了修改4KB数据,内部可能搬迁几MB数据,效率显然很低。因此,更灵活的办法是采用Page级映射。每一个逻辑Page都可以指向任意一个物理Page。这样随机写入更加自由,垃圾回收也更容易进行。
但映射粒度越细,映射表就越大。
以一块4TB SSD为例,如果按照4KB粒度建立映射,就大约需要十亿条映射记录。即使每条记录只占4Byte,完整映射表也需要大约4GB内存,还没有计算其他元数据。
早期Controller不可能提供这么大的SRAM或者DRAM。
于是,FTL的发展开始围绕一个矛盾展开:
Block级映射占用内存少,但更新效率低;Page级映射更加灵活,却需要庞大的映射表。
2007年的FAST采用日志块和混合映射,希望通过少量Page级映射,缓冲主机发来的更新数据,从而减少频繁的Block合并。[3]
它没有完全使用Page级映射,而是在内存占用与写入效率之间寻找折中。
到了2009年,DFTL提出了另一种思路:完整的Page级映射表仍然保存在NAND中,但DRAM里只缓存当前经常访问的那部分映射。[4]
这样一来,Firmware不需要把整张L2P表长期放在DRAM中,却仍然可以获得Page级映射的灵活性。
从FAST到DFTL,可以看到早期FTL演进的一条清晰路线:
Firmware已经知道数据放在哪里了,但还要想办法以尽可能低的成本记住这些位置。
然而,当新的数据不断被写入新位置以后,旧位置也会不断失效。失效Page越来越多,SSD内部的空闲空间迟早会被耗尽。
于是,Firmware又不得不解决下一个问题:怎样把这些废弃空间重新利用起来?
四、地址映射解决了写入,垃圾回收却制造了写放大
主机更新数据以后,旧Page只是被标记为无效,并不会立刻从NAND中消失。
原因很简单:NAND不能单独擦除一张Page,只能一次擦除整个Block。
假设一个Block中有1000个Page,其中900个已经无效,但还有100个数据仍然有效。
Firmware不能直接擦除这个Block。它必须先读取剩余的100个有效Page,把它们搬到其他位置,然后才能擦除原来的Block。这个过程就是Garbage Collection,也就是垃圾回收。
垃圾回收让NAND空间能够循环使用,却带来了一个新的问题。
主机可能只写入了4KB数据,SSD内部却因为整理空间,又额外搬迁了许多有效数据。
主机写入量与NAND实际写入量之间的比值,就是写放大。
2008年的《Design Tradeoffs for SSD Performance》系统分析了SSD内部的数据放置、并行性、垃圾回收和磨损均衡等问题,并指出SSD性能与寿命高度依赖工作负载和Firmware策略。[5]
2009年的写放大分析进一步研究了垃圾回收、预留空间与写放大之间的关系。[6]
这意味着,一块SSD能够使用多久,并不只由NAND标称的P/E次数决定。它还取决于Firmware如何管理空间。
同样写入1TB主机数据,一套Firmware可能只向NAND写入1.2TB,另一套Firmware却可能写入3TB。后者不仅性能更差,也会更快消耗NAND寿命。
垃圾回收策略还会直接影响前台IO。
如果Firmware等到空闲Block快要耗尽时才开始回收,主机写入就可能被迫等待垃圾回收完成,形成明显的性能抖动。
如果它提前在后台进行回收,又可能抢占正常IO需要的NAND资源。
所以,Firmware需要不断判断:
什么时候启动垃圾回收?
选择哪个Block作为回收对象?
后台任务应该占用多少资源?
是否应该利用设备空闲时间提前整理空间?
与此同时,NAND Block的擦除寿命又是有限的。Firmware还必须避免某些Block被反复擦除,而另一些Block长期闲置。
于是,磨损均衡又加入了进来。
到这里,Firmware已经不再只是维护一张地址表。
它开始像一个资源管理器一样,在空间、性能与寿命之间持续进行调度。
但至少在这一阶段,人们仍然隐含地假设一件事:
只要知道数据存在哪里,数据就应该能够被正确读出来。
随着NAND从SLC走向MLC、TLC和QLC,这个前提也开始动摇。
五、NAND越来越密,Firmware开始负责“抢救数据”
SLC的一个Cell只需要区分两种状态。
到了MLC、TLC和QLC,一个Cell中需要区分的状态越来越多,留给每个状态的阈值电压窗口也越来越窄。
与此同时,制程不断缩小,Cell中可用于表示数据的电子数量减少,Cell之间的干扰、数据保持衰减和读干扰问题却变得更加明显。
2012年的《The Bleak Future of NAND Flash Memory》指出,随着制程缩小和单个Cell存储位数增加,NAND的性能、寿命与可靠性会同时面临压力。[7]
后续大量NAND可靠性研究也表明,阈值电压分布会随着P/E次数、保存时间、读取次数和温度发生变化。[8]
这让Firmware承担了一个全新的角色。
它不再只是记录数据的位置,还必须判断:
这份数据现在是否仍然可靠?
默认Read Level是否还适合当前NAND状态?
ECC失败以后是否需要Read Retry?
什么时候需要进行Soft Read?
某个Block是否已经不适合继续保存数据?
要不要在错误继续恶化以前,提前将数据搬走?
也就是说,现代SSD中的ECC、Read Retry、Vth Tracking、Soft Read、Read Reclaim和RAID,并不是彼此孤立的功能。
它们共同组成了一套由Firmware编排的数据恢复流程。
早期Firmware面对的是一个确定的存储介质:写进去什么,理论上就能读出来什么。
现代Firmware面对的却更像一个不断变化的模拟信道。同一份数据昨天可以一次读出,今天可能需要调整Read Level,明天可能要进入Soft Decode,之后还可能需要依靠RAID才能恢复。
Firmware开始不断观察NAND的健康状态,并在数据真正丢失以前主动采取措施。
可是,即使用户数据本身能够依靠ECC和重读恢复,SSD内部还有另一类非常重要的数据也需要保护。那就是Firmware自己的meta data。
六、突然掉电,丢失的可能不只是最后一笔数据
SSD运行时,很多关键状态会暂存在DRAM或者SRAM中。
例如L2P映射表、Block状态、空闲Block列表、垃圾回收进度以及尚未完成的写入日志。
如果设备正常关机,Firmware可以按照既定顺序,把这些数据保存到NAND中。
但如果突然断电,事情就没有这么简单。
主机数据可能已经写入NAND,但对应的L2P映射尚未完成更新。
也可能映射表已经更新,数据却只写了一半。
垃圾回收还可能刚刚搬迁了一部分Page,旧Block和新Block都处于中间状态。
2013年,研究人员对来自5家厂商的15块商用SSD进行了3000多次掉电故障注入测试。
结果发现,其中13块SSD出现了不同程度的异常,包括Bit Corruption、Shorn Write、写入顺序异常、元数据损坏,甚至整块SSD无法再次识别。[9]
这说明SSD的掉电保护,并不只是想办法把最后几KB用户数据写完。
更重要的是保证Firmware自己的内部状态仍然一致。
因此,现代Firmware需要维护日志、检查点和元数据副本,并设计完整的启动恢复流程:
上一次关机是否正常?
哪一份映射表是最新的?
中断的写入是否已经完成?
执行到一半的垃圾回收应该继续,还是回滚?
哪些Block中的数据仍然有效?
企业级SSD还会配合电容等硬件,在检测到电压下降后,为Firmware争取最后一段运行时间,将关键数据和元数据写入NAND。
到了这一步,Firmware已经具备了数据库和文件系统中常见的日志、事务与故障恢复思想。
但随后,SSD的发展又遇到了另一种压力。
以前Firmware最主要的对手,是NAND本身的物理限制。
NVMe出现以后,它还必须追上主机越来越高的并发能力。
七、NVMe让Firmware从控制程序变成并发系统
SATA和AHCI最初主要面向机械硬盘设计。
机械硬盘本身的并行能力有限,一次只能让磁头在一组盘片上完成访问,因此接口并不需要支持特别复杂的多队列并发。
SSD却完全不同。
它内部有多个Channel、多个Die和多个Plane,大量NAND操作可以并行执行。
如果主机接口一次只能发送少量命令,SSD内部的并行能力就无法被充分利用。
2011年发布的NVMe 1.0,开始直接面向PCIe固态存储设计,通过多队列和更深的命令队列,提高主机与SSD之间的并发能力。[10]
但接口变快以后,Firmware的工作并没有减少,反而变得更加复杂。
它需要同时处理大量命令,并将这些命令分配给不同的NAND资源。
一条IO可能先经过NVMe命令解析,再经过地址转换、缓存管理、ECC处理、NAND调度和DMA传输,最后才能向主机报告完成。
与此同时,后台还可能运行垃圾回收、磨损均衡、数据刷新和温度管理。
如果所有任务都在一个CPU Core上串行执行,那么即使NAND与PCIe拥有很高的并行能力,也会被Firmware本身卡住。
2020年的DeepFlash研究,已经把SSD Firmware视为一个真正的多核并发软件系统。
它将NVMe队列处理、地址翻译和Flash调度拆分为多个阶段,再分配给不同的Core并行执行。[13]
但Core数量增加以后,又会产生新的问题:
多个Core能否同时查询和更新映射表?
两个IO是否可能访问同一份元数据?
后台垃圾回收如何与前台写入同步?
出现竞争以后,应该加锁还是重新拆分数据结构?
这些问题与操作系统和数据库中的并发控制已经非常相似。
所以说现代SSD Firmware像一套小型操作系统,并不是一种夸张的比喻。
它确实需要管理任务、内存、硬件资源、并发、后台线程和异常恢复。
然而,无论Firmware内部做得多么聪明,它始终还存在一个无法独自解决的问题:
它看得到IO,却不知道这些IO代表什么。
八、只看得到LBA的Firmware,开始向主机索要更多信息
对于Firmware来说,主机写入的数据只是一串LBA。
它不知道哪些数据属于数据库日志,哪些数据属于用户文件,也不知道哪些数据几分钟后会失效,哪些数据几年都不会发生改变。
如果不同生命周期的数据被混合写入同一个Block,当其中一部分数据失效时,Firmware就不得不搬迁剩余的有效数据。
这会增加垃圾回收成本和写放大。
Firmware当然可以根据访问历史猜测数据冷热,但它不可能完全理解上层应用的真实语义。
2014年的Multi-stream SSD提出了一种新的思路。
主机在写入数据时,为不同生命周期的数据分配不同的Stream。Firmware再尽量把生命周期相近的数据放进相同的擦除单元。[11]
例如,数据库日志可以放在一个Stream中,长期保存的用户数据放在另一个Stream中。
这样,当日志整体失效时,对应Block就更有可能直接被回收,而不需要搬迁大量长期有效的数据。
这代表SSD Firmware发展方向的一次变化。
以前的目标,是尽量把NAND的所有内部细节隐藏在设备里。
现在,人们开始意识到,完全封闭的黑盒也会阻碍优化。
2017年的LightNVM和Open-Channel SSD进一步打开了这只黑盒。
它把部分物理地址、并行资源和介质约束暴露给主机,允许主机参与数据放置和IO调度,甚至可以把FTL的一部分功能转移到主机端。[12]
这并不意味着Firmware会消失。
相反,问题变成了:
哪些功能应该留在SSD内部?
哪些信息应该交给主机?
主机提供数据语义以后,Firmware应该保留多少自主权?
从完全封闭的FTL,到Stream、Open-Channel以及后续的主机与设备协同方案,可以看到SSD发展的另一条主线:
Firmware不再试图独自猜测所有事情,而是开始与主机共同管理数据。
九、Firmware的历史,就是职责不断扩张的历史
回顾整个过程,会发现SSD Firmware的发展并不是简单地不断增加新功能。
每一代功能,都是为了解决上一代架构暴露出来的新问题。
最早,Firmware只需要接收主机命令并驱动存储器。
NAND不能覆盖写,于是出现了FTL和地址映射。
映射表太大,于是出现了混合映射、映射缓存和DFTL。
无效Page不断积累,于是出现了垃圾回收。
垃圾回收产生额外写入,于是开始研究写放大和预留空间。
Block寿命有限,于是需要磨损均衡。
NAND可靠性下降,于是Firmware开始管理ECC、Read Retry、Soft Read和数据刷新。
异常掉电会破坏内部状态,于是又加入日志、检查点和启动恢复。
NVMe带来高并发,Firmware逐渐变成多核并行系统。
完全封闭的黑盒无法理解上层数据语义,于是主机与设备开始共同参与数据放置。
所以,今天的SSD Firmware早已不是一段简单的底层驱动。
它同时管理着:
地址、空间、寿命、可靠性、并发、功耗、温度与异常恢复。
NAND决定了一块SSD的物理边界。
Controller提供了执行这些功能的硬件基础。
而Firmware决定了SSD如何在这些限制之间做出选择。
它决定哪些数据放在哪里,什么时候搬迁,什么时候回收,什么时候降速,以及数据出错以后还能不能被救回来。
到这里,我们就能理解为什么SSD不是几颗NAND焊起来就能使用。
因为真正让这些NAND表现为一块完整存储设备的,并不是某一个单独算法。
而是一整套在几十年中不断生长出来的Firmware系统。
谢谢你看我的文章 。
参考文献
[1] Gopi Kuppan Thirumalai. A Beginner’s Guide to SSD Firmware. Apress, 2023. Chapter 3: The History and Evolution of SSD Firmware.
[2] Eran Gal, Sivan Toledo. “Algorithms and Data Structures for Flash Memories.” ACM Computing Surveys, Vol. 37, No. 2, 2005.
[3] Sang-Won Lee, Dong-Joo Park, Tae-Sun Chung, et al. “A Log Buffer-Based Flash Translation Layer Using Fully-Associative Sector Translation.” ACM Transactions on Embedded Computing Systems, Vol. 6, No. 3, 2007.
[4] Aayush Gupta, Youngjae Kim, Bhuvan Urgaonkar. “DFTL: A Flash Translation Layer Employing Demand-based Selective Caching of Page-level Address Mappings.” ASPLOS, 2009.
[5] Nitin Agrawal, Vijayan Prabhakaran, Ted Wobber, et al. “Design Tradeoffs for SSD Performance.” USENIX Annual Technical Conference, 2008.
[6] Xiangyu Hu, Evangelos Eleftheriou, Robert Haas, et al. “Write Amplification Analysis in Flash-Based Solid State Drives.” SYSTOR, 2009.
[7] Laura M. Grupp, John D. Davis, Steven Swanson. “The Bleak Future of NAND Flash Memory.” FAST, 2012.
[8] Yu Cai, Saugata Ghose, Erich F. Haratsch, Yixin Luo, Onur Mutlu. “Errors in Flash-Memory-Based Solid-State Drives: Analysis, Mitigation, and Recovery.” 2017.
[9] Mai Zheng, Joseph Tucek, Feng Qin, Mark Lillibridge. “Understanding the Robustness of SSDs under Power Fault.” FAST, 2013.
[10] NVM Express Workgroup. NVM Express Revision 1.0. 2011.
[11] Jeong-Uk Kang, Jeeseok Hyun, Hyunjoo Maeng, Sangyeun Cho. “The Multi-streamed Solid-State Drive.” USENIX HotStorage, 2014.
[12] Matias Bjørling, Javier González, Philippe Bonnet. “LightNVM: The Linux Open-Channel SSD Subsystem.” FAST, 2017.
[13] Jie Zhang, Miryeong Kwon, Michael Swift, Myoungsoo Jung. “Scalable Parallel Flash Firmware for Many-core Architectures.” FAST, 2020.
 Alipay
 Wechat