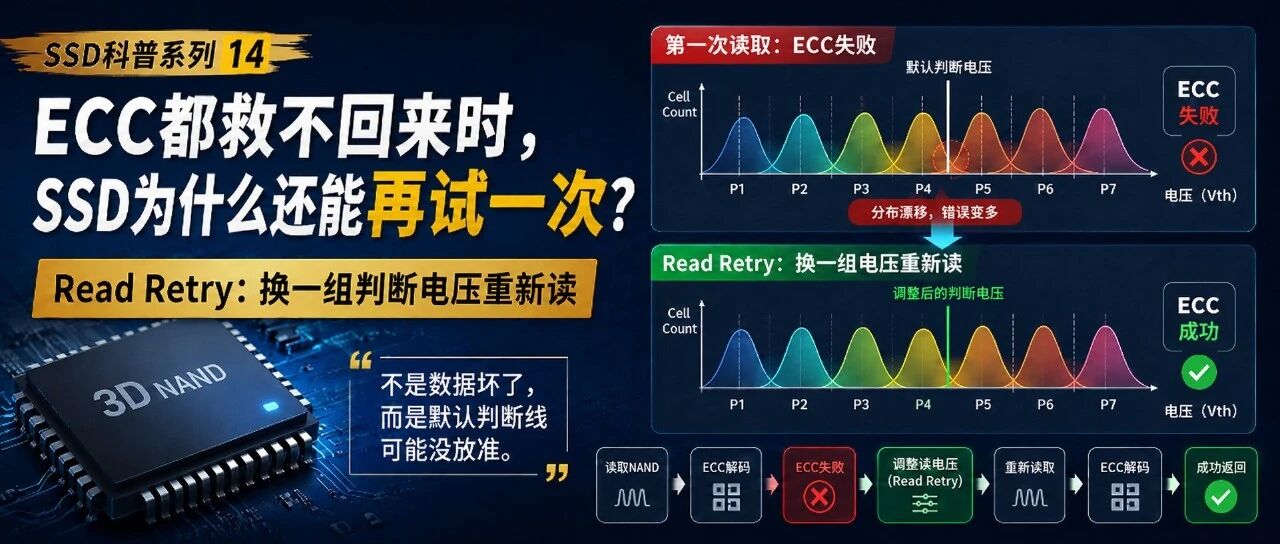
上一篇我们讲到一个核心观点:
NAND 数据不是天然干净地读出来的,而是被 ECC 救回来的。
主机发来一个 read 命令,SSD 从 NAND 里读出一页数据。 这份数据不是百分百正确的,里面可能已经有很多 bit 读错了。
这时候 ECC 出场。
如果错误数量还在 ECC 的能力范围内,ECC 就能把这些错 bit 修回来,然后 SSD 把正确数据返回给主机。
所以从主机视角看:
数据读取成功。
但从 SSD 内部看,真实过程其实是:
NAND 原始读取↓出现 bit error↓ECC 纠错↓纠回来↓返回正确数据
问题来了。
如果 ECC 也救不回来呢?
是不是就说明数据彻底坏了? 是不是 SSD 只能上报不可纠错错误? 是不是这页数据已经没救了?
不一定。
在真实 SSD 里,ECC 第一次失败,通常还不是终点。
因为控制器还会先怀疑另一件事:
会不会不是数据真的死了,而是这一次读取时,是判断电压没有放准?
于是,SSD 会换一组读取条件,再读一次。
这个动作,就是 Read Retry。
一、ECC 失败,不等于数据立刻死亡
很多人会把 ECC 失败理解成:
这页数据坏了。
但更准确的说法是:
在当前这次读取结果下,错误 bit 太多,ECC 暂时救不回来。
注意这里有两个关键词:
当前这次读取结果。
NAND 读数据不是像硬盘那样,把某个磁区里的数据直接“拿出来”。NAND cell 里真正存的是电压状态。读数据时,SSD 要根据这些电压状态判断它属于哪个逻辑状态。
换句话说,NAND read 的本质不是“取出答案”,而是:
根据电压位置,判断这个 cell 更像哪个状态。
如果判断电压选得不合适,就可能把一些本来还能分清的 cell 判错。
于是 raw bit error 增加。 ECC 看到的错误变多。 如果错误多到超过 ECC 能力,ECC 就失败。
但这并不一定代表 cell 里的信息已经完全消失。
它可能只是说明:
这次读的时候,判断线放错了位置。
二、NAND 读取,其实是在电压分布之间画分界线
以 TLC 为例,一个 cell 存 3 bit,需要区分 8 种状态。
可以先抽象成这样:
E P1 P2 P3 P4 P5 P6 P7
这些状态不是一个个精确的点,而是一段段电压分布。
更像这样:
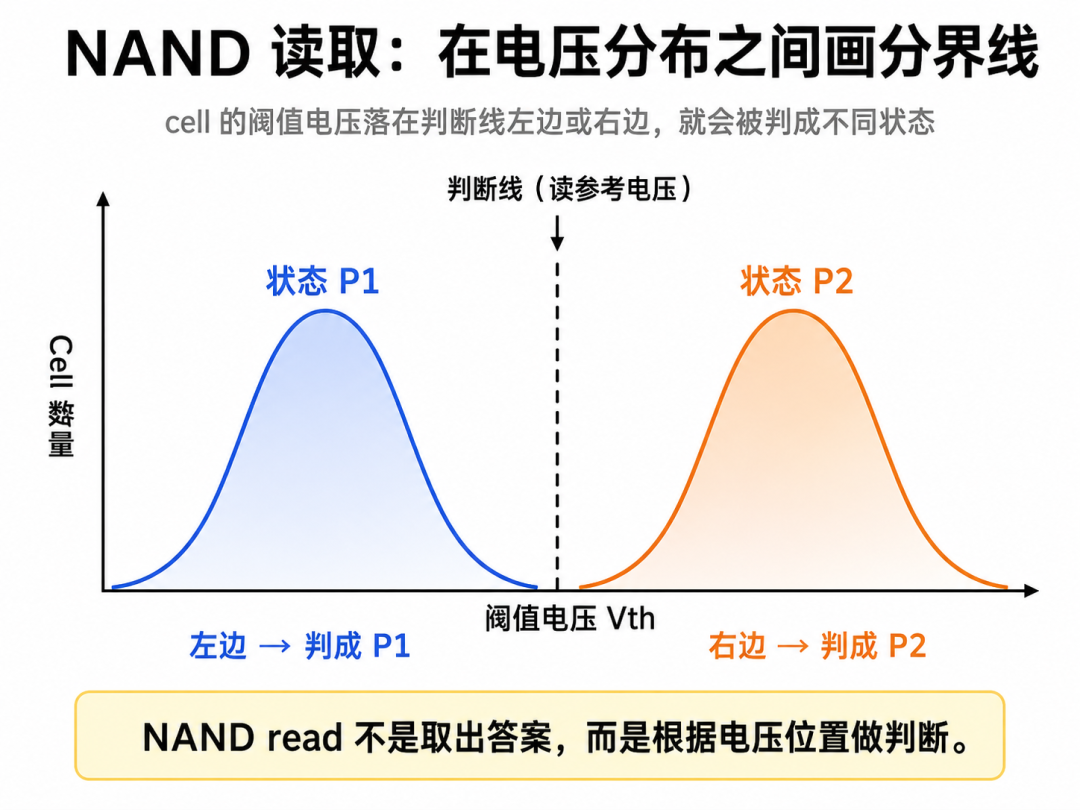
读的时候,SSD 要在相邻状态之间放一条判断线。
如果 cell 的阈值电压在判断线左边,就判成一种状态。 如果在判断线右边,就判成另一种状态。
所以 NAND read 的底层逻辑可以简化成:
测到 cell 的电压状态↓和 read 参考电压比较↓判断它落在哪个区间↓转换成 bit 数据
这里的 read reference voltage,可以理解为“判断线”。
问题是,这条判断线不是永远都刚好合适。
三、为什么默认判断线会不准?
刚写完数据时,各个状态之间的分布相对清楚。
判断线放在中间,比较安全:
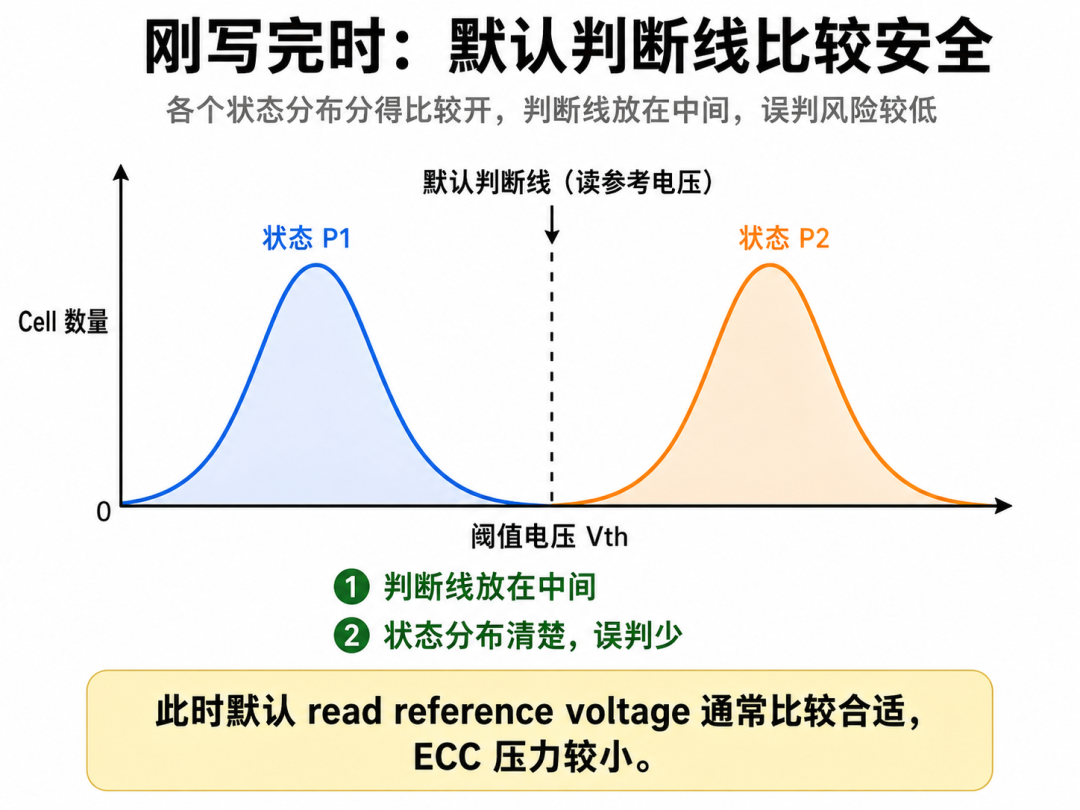
但 NAND 的状态会变化。
比如:
P/E 次数增加数据放置时间变长温度变化读 disturb 累积相邻 cell 干扰program 后状态继续变化
这些因素都会让阈值电压分布变宽、偏移,甚至互相靠近。
一段时间后,可能变成这样:
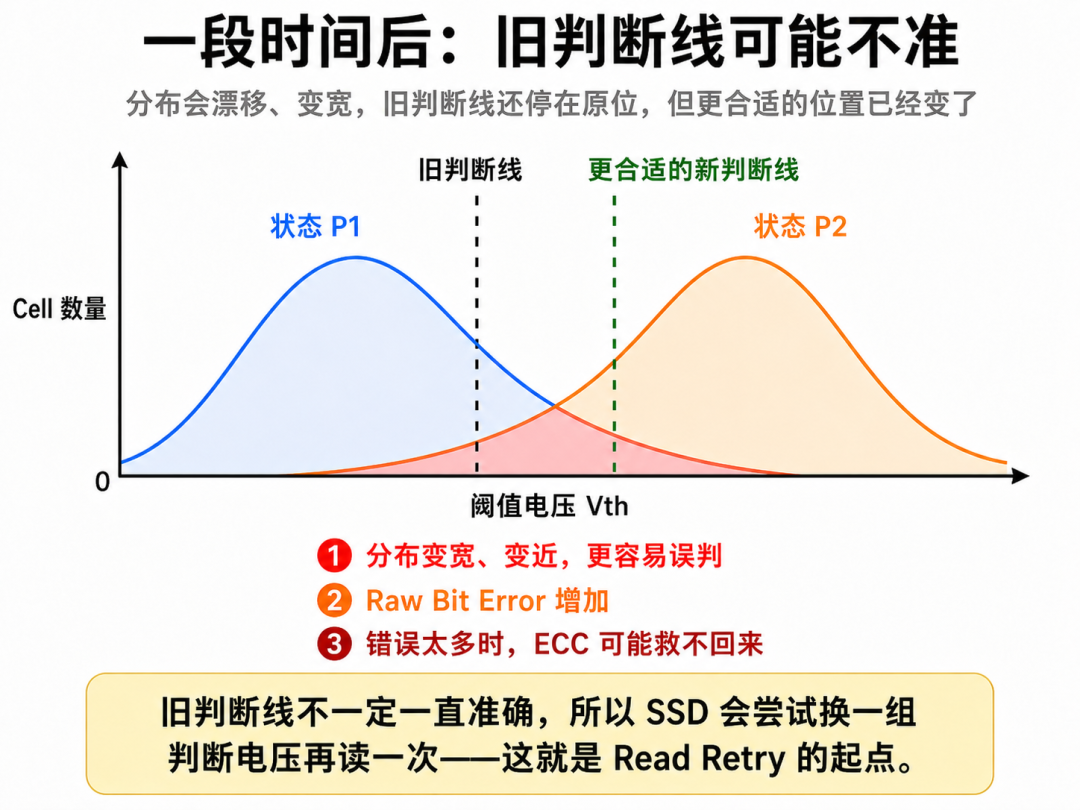
旧判断线还停在原来的地方,但电压分布已经变了。这时候,一部分 cell 就可能被误判。如果误判数量少,ECC 可以救。 如果误判数量太多,ECC 就救不回来。但这时候 SSD 不会马上认输。
它会尝试:
既然这条判断线不准,那就换一条判断线再读一次。
这就是 Read Retry 的起点。
四、Read Retry 不是“再读一遍”这么简单
Read Retry 这个名字很容易让人误解。
很多人会以为它就是:
读失败了,再读一遍。
这个说法太粗了。
如果 SSD 用完全一样的 read reference voltage、完全一样的方式再读一遍,那大概率还是一样的结果。
Read Retry 真正做的是:
换一组 read reference voltage,再读一次。
也就是:
第一次读取:使用默认判断电压↓ECC 失败↓ReadRetry:切换另一组判断电压↓重新读取↓ECC 再次尝试纠错
所以 Read Retry 不是碰运气。
它更像是:
第一次量的时候,尺子放歪了。 现在重新调整尺子的位置,再量一次。
最核心的一句话就是:
Read Retry 不是重复读,而是换一组判断电压重新读。
五、ECC 和 Read Retry 到底是什么关系?
这两个东西很容易混。
ECC 的任务是:
已经读出来一堆 bit,其中有些错了,我尽量把错 bit 找出来并修回来。
Read Retry 的任务是:
这次读出来错太多了,那我换一组读取电压,让下一次读出来的错误少一点。
所以它们不是替代关系,而是配合关系。
可以这样理解:
NAND 第一次读取↓ECC 尝试纠错↓ECC 成功↓返回正确数据
如果 ECC 失败:
NAND 第一次读取↓ECC 尝试纠错↓ECC 失败↓ReadRetry调整读取电压↓重新读取 NAND↓ECC 再尝试纠错↓如果成功,返回正确数据
用一个比喻:
ECC 是医生。 Read Retry 是重新拍片。
第一次片子太模糊,医生判断不了。 那就换一个角度、换一个曝光,再拍一张。 片子清楚一点,医生才有机会把问题看出来。
所以更准确的说法是:
ECC 是救错 bit,Read Retry 是让错 bit 变少。
六、TLC 里,Read Retry 调的不是一条线,而是一组线
如果是 SLC,只有两个状态,中间主要是一条判断边界。但 TLC 不一样。TLC 有 8 个状态,中间有多条判断边界。
可以抽象成:
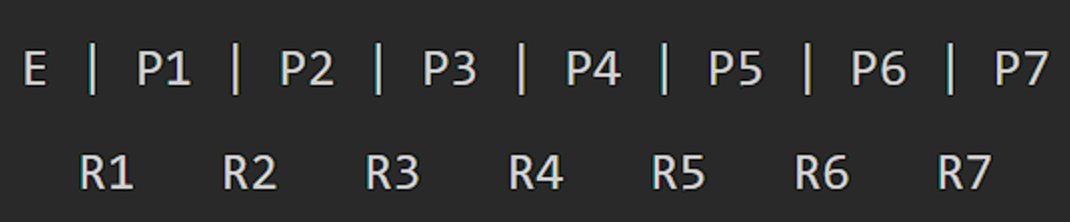
R1 到 R7,就是相邻状态之间的判断线。
所以 TLC Read Retry 不是简单地:
把所有 read voltage 都加一点。
也不是:
把所有 read voltage 都减一点。
真实情况更复杂。
有些判断线可能要往低电压方向挪。 有些判断线可能要往高电压方向挪。 有些判断线可能不用动。 有些判断线可能要调得更多。
原因很简单:
NAND 的电压分布不是所有状态一起整齐移动,而是不同状态、不同边界受到的影响都不一样。
所以一次 Read Retry,通常不是调一个电压,而是切换一组读取配置。
可以抽象成:
默认读取:R1 R2 R3 R4 R5 R6 R7都在默认位置RetryProfile A:换一组 R1~R7 的位置RetryProfile B:再换另一组 R1~R7 的位置RetryProfile C:继续换另一组 R1~R7 的位置
这就解释了为什么 Read Retry 是一个系统性的读恢复动作,而不是简单重读。
七、为什么不同 page 读法还不一样?
TLC 里有 lower page、middle page、upper page。
不同 page 读取时,关心的判断边界不完全一样。
可以粗略理解成:
Lower page:关心某几条判断线Middle page:关心另外几条判断线Upper page:又关心另外几条判断线
所以 controller 做 Read Retry 时,不是只知道:
这个 block 是 TLC。
还要知道:
当前读的是哪类 page? 这类 page 涉及哪些 read level? 这次应该切换哪一组 retry profile?
这就是固件里的复杂性。
从外面看,Read Retry 好像只是“读失败后再试一次”。
但在 controller 里面,它更像一套流程:
判断当前 page 类型↓选择对应的read retry profile↓切换读取电压↓重新读取↓ECC 再解码↓根据结果决定继续retry还是结束
所以 Read Retry 不是一个孤立动作。它和 NAND 的 page mapping、read level、ECC、读恢复流程都绑在一起。
八、Read Retry 不一定一次救完整页
还有一个细节很关键。很多人会以为,Read Retry 每试一次,要么整页成功,要么整页失败。
但从 SSD 控制器视角看,它可以更细。一页 NAND 数据通常会被 ECC 切成多个 codeword。 每个 codeword 可以分别判断是否纠错成功。
于是可能出现这种情况:
第一次读取:codeword 0成功codeword 1成功codeword 2失败codeword 3失败
控制器不会把已经成功的部分扔掉。
它会先保存已经救回来的 codeword。
然后进入 Read Retry:
第一次retry:codeword 2成功codeword 3仍然失败
那就继续保存 codeword 2。
再换一组读取电压:
第二次retry:codeword 3成功
最后,这一页数据可能不是靠某一次 read 完整救回来的,而是靠多次 retry,把不同 codeword 分批救回来。
主机看到的只是:
read 成功。
但 SSD 内部可能经历的是:
第一次读,救回一部分↓第一次retry,又救回一部分↓第二次retry,最后一部分也救回来↓拼成完整页↓返回主机
这就是 Read Retry 很有意思的地方。
它不是一次性奇迹,而是一次次把数据从错误边缘往回拉。
九、Read Retry 的代价:读延迟变长
Read Retry 能提高读成功概率,但它不是免费的。
因为每 retry 一次,就意味着:
重新设置读取条件↓重新读 NAND↓重新做 ECC 解码
这一定会增加读延迟。
普通情况下:
一次 read↓ECC 成功↓返回数据
触发 Read Retry 后:
第一次 read↓ECC 失败↓切换retry profile↓第二次 read↓ECC 失败↓再切换retry profile↓第三次 read↓ECC 成功↓返回数据
读是成功了,但时间明显变长。
这也是为什么有些 SSD 在健康状态下延迟比较稳定;但当 NAND 老化、数据放置时间变长、错误率上升时,读延迟的尾巴会变长。
不是 SSD 忽然变慢。而是它在背后做了更多抢救。
一句话:
Read Retry 救的是可靠性,付出的代价是时间。
十、什么情况下更容易触发 Read Retry?
Read Retry 通常更容易出现在这些场景:
P/E 次数变高数据放置时间变长温度发生明显变化读 disturb 累积相邻 cell 干扰变强TLC / QLC 这类高密度 NAND
这些场景背后有一个共同点:
Vth 分布变宽了、偏移了、重叠了,默认 read level 不再足够准确。
新盘、低 P/E、刚写完不久的数据,默认判断线通常还比较好用。但 NAND 用久之后,状态会越来越模糊。
这时候,SSD 就越来越依赖一整套读恢复机制:
ECCReadRetryread calibrationsoft information风险数据搬迁/数据刷新/ recycle
这些机制不是各干各的,而是形成了一条链:
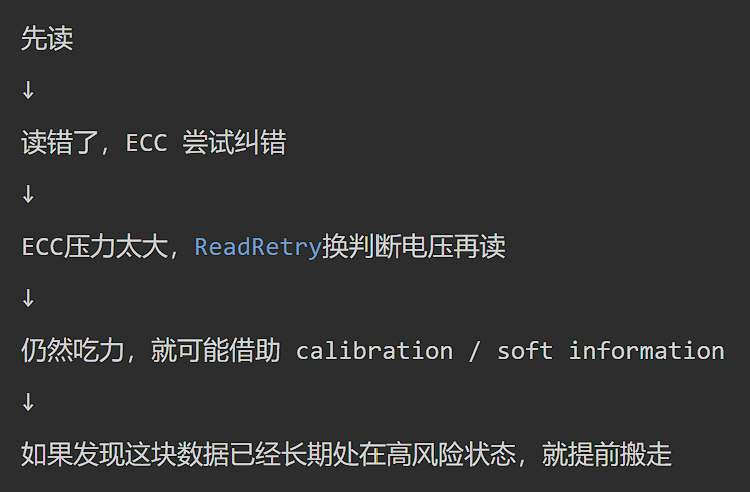
所以 Read Retry 不是孤立存在的。
它通常意味着:
默认读法已经不够稳了,SSD 需要用更复杂的方式,把原本越来越模糊的数据重新救回来。
十一、Read Retry 和“风险数据搬迁”的关系
Read Retry 可以把数据救回来。但如果某个 block / SPB 里的数据经常要靠 Read Retry 才能读出来,这不是一个好信号。
这说明:
这块数据已经越来越难读了。
SSD 控制器不会每次都等到读失败才临时抢救。
它可能会在某次成功读回数据后,做一个更主动的动作:
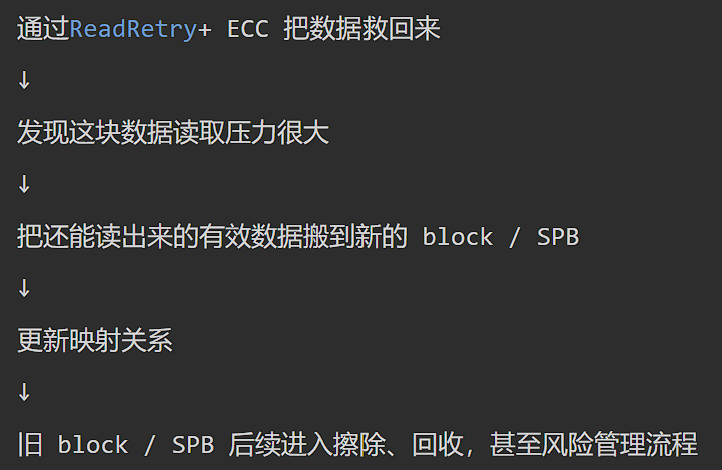
这个动作可以叫:
风险数据搬迁数据刷新data refreshrecycleSPB recycle
具体叫法要看不同公司的固件实现。
但它背后的思想是一样的:
不要等数据彻底读不出来再处理。 趁现在 ECC 和 Read Retry 还能救回来,先把数据搬到更安全的位置。
它看起来有点像 GC,因为两者都会做数据搬迁:
读旧位置的有效数据↓写到新位置↓更新 L2P /映射信息↓旧位置失效,等待后续回收
但触发原因不同。
GC 更多是为了:
回收空间。
这里的风险数据搬迁更多是为了:
保护数据,避免以后真的读不回来。
因此:
如果某个 block / SPB 经常需要 Read Retry 才能读出来,SSD 可能不会继续让数据留在原地。控制器会趁数据还能被 ECC 救回来时,把它搬到新的位置。这个过程在固件实现里可能表现为一次 recycle 或数据刷新。它和普通 GC 很像,但目的不是单纯腾空间,而是降低后续读失败的风险。
十二、把 ECC 和 Read Retry 串起来看
现在我们把上一篇 ECC 和这一篇 Read Retry 放在一起,就能看到 SSD 内部真正的读流程。
不是:
主机发 read↓SSD 返回数据
而是:
主机发 read↓SSD用默认read level读取NAND↓得到一份带错误的原始数据↓ECC 尝试纠错↓如果 ECC 成功,返回数据↓如果 ECC 失败,进入ReadRetry↓切换 read retry profile↓重新读取 NAND↓ECC 再次尝试纠错↓如果部分 codeword 成功,先保存↓继续尝试其他retry profile↓如果最终拼回完整页,返回主机↓如果仍然失败,再进入更复杂恢复流程或上报不可纠错错误
这才是现代 SSD 读数据更真实的样子。
不是一次读取就结束。 不是 ECC 失败就马上宣判。 而是在多层恢复机制之间不断尝试。
十三、为什么 TLC / QLC 更离不开 Read Retry?
SLC 只有两个状态。
E | P
状态间隔大,判断相对宽松。而TLC 有 8 个状态。 QLC 有 16 个状态。状态越多,每个状态之间的电压间隔越小。
可以粗略理解成:
SLC:两个状态,间隔大,比较好判TLC:八个状态,间隔小,判断更难QLC:十六个状态,间隔更小,判断更难
电压窗口越窄,对 read reference voltage 越敏感。一点点漂移,就可能让默认判断线不再合适。所以越是高密度 NAND,越需要更复杂的读恢复机制。
这也是现代 SSD 的本质矛盾:
NAND 要越来越便宜,容量要越来越大。 但每个 cell 里的电压空间越来越挤,数据状态越来越难分。 于是 controller 必须越来越聪明。
ECC 是其中一层。 Read Retry 是另一层。 后面还有 read calibration、soft decode、风险数据搬迁 等一整套机制。
结尾:ECC 救不回来时,SSD 还会先换一把尺子
上一篇我们说:
NAND 数据不是读出来的,而是被 ECC 救回来的。
这一篇可以再往前推进一步:
如果 ECC 第一次救不回来,SSD 也不会马上放弃。
它会先怀疑:
是不是我这次读的时候,判断线没有放准?
于是它切换一组 read reference voltage,重新读取同一页,再把新的结果交给 ECC。
所以 Read Retry 的本质不是:
读失败了,再读一遍。
而是:
默认判断电压不准时,SSD 换一组判断电压,再给 ECC 一次救数据的机会。
这句话把 ECC 和 Read Retry 的关系讲清楚了。
ECC 负责把错 bit 救回来。 Read Retry 负责让错 bit 尽量变少。 两者一起,才构成 SSD 读恢复的核心路径。
用户以为 SSD 只是“读了一下数据”。 但在 SSD 内部,可能已经经历了:
判断↓纠错↓失败↓换电压↓再判断↓再纠错↓拼回数据
所以现代 SSD 的可靠性,不是 NAND 本身永远不出错。
而是当 NAND 开始模糊、漂移、读错时,控制器还能一层一层把数据救回来。
 谢谢你看我的文章!
 Alipay
 Wechat