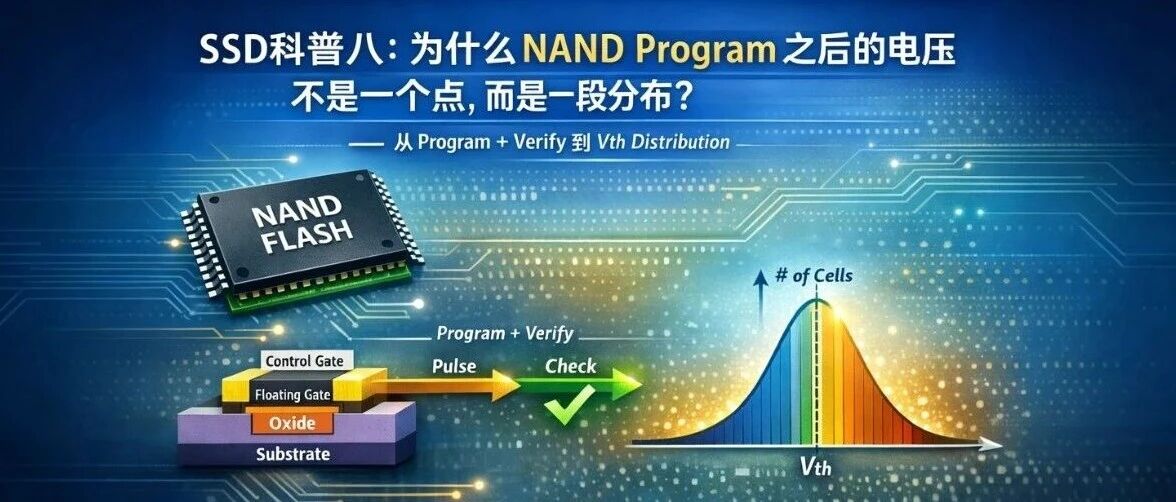
为什么要先讲 NAND Program?
我觉得这个问题很有必要单独拿出来讲。
因为 NAND 在 program 之后的电压分布,几乎是每一个初学者都绕不开的东西。
我刚接触 NAND 的时候,也困惑了很久:
为什么 program 之后的电压,不是一个固定值,而会形成一个“类似正态分布”的图?
这个问题如果没想明白,后面很多内容其实都很难真正看懂,比如:
NAND Read 是怎么判决的
为什么 TLC/QLC 读取更复杂
为什么会有 Read Retry
为什么 ECC 必不可少
所以我一直觉得,先把 program 讲明白,再去讲 read,顺序会更自然。
从 SSD 固件视角看,一笔写入是怎么走的?
站在 SSD 固件的角度来看,一般可以把整个数据路径分成三部分:
前端:和 Host 打交道
中端:FTL
后端:和 NAND 打交道
这里说的 Host,你可以简单理解成上层软件。比如说 Word。
假设你在 Word 里面编辑了一段文字,然后点击了“保存”。
很多人的直觉会觉得:
点了保存,数据就已经写到 SSD 里面去了。
但实际上并不是这样。
通常在点击保存的那一刻,数据先进入的是 系统内存(DDR),并没有立刻落到 SSD 里。
当关闭 Word,或者系统觉得时机合适时,才可能通过 flush 等机制,把系统内存里的内容真正下刷到 SSD。
如果从 SSD 固件角度去看,一笔 Host 写大概是这样走的:
对前端来说:
前端负责接收 Host 发下来的写命令和写数据。当前端把数据都收齐以后,就会把这笔写命令完成并返回给 Host。
对 FTL 来说:
FTL 需要在 SSD 内部申请一块缓存空间,把前端送过来的写数据先接住。等数据准备好之后,再把对应的写命令组织起来,下发给后端。
对后端来说:
后端负责接收 FTL 下来的命令,然后真正把数据写入 NAND。
这是一条非常普通、但也是 SSD 里最重要、最繁忙的写路径。几乎所有的 Host 写,最后都要走到这里。
在真正写入 NAND 之前,数据还会经过 NAND Controller 做一些处理,比如:
随机化(Randomization)
ECC 编码
数据搬运和对齐
其中随机化的目的,简单来说就是让数据在 0 和 1 的分布上更均匀一些,这样写下去之后,整体稳定性会更好。这个问题这里先一笔带过,后面有机会可以再单独展开。
为什么写下去之后的数据不是一个“点”,而是一个分布?
这个问题,我自己也查了不少资料,后来才慢慢想明白。
先从最简单的情况开始。
我们知道,program 操作是按照 page 顺序 从小到大依次进行的。目前常见的 page 大小是 16KB。
一个 page 是由很多个浮栅晶体管组成的,也就是我们常说的 cell。
假设这里先讨论最简单的 SLC。
SLC 的特点是:
一个 cell 只存储 1 bit
所以一个 cell 只可能表示 0 或 1
如果一个 page 是 16KB,那么它一共有:
16 × 1024 × 8 = 131072 bit
也就是说,这一个 page 里,大概就有 131072 个 cell。
我们直觉上理解的“写入”,其实是不对的
之前文章里提到过,program 的本质就是加高电压,把电子打进浮栅层里。
如果站在直觉上理解,很多人会觉得:
对于 SLC 来说,只要这个 cell 里电子数量超过某个门限,比如“超过 50%”,那它就可以表示成 1。
所以看起来好像很简单:
加高电压
把电子打进去
超过阈值就行了
但 NAND 的真实操作和我们这种直觉其实是反着来的。
它不是在“写 bit”,不是在写入 0 或 1。
它真正做的事情是:
向浮栅层中注入电子,改变这个 cell 的阈值电压。
这是一个模拟过程,不是数字过程。
这一点非常关键。
Program 不是一次打进去,而是 Program + Verify
NAND 的 program 并不是:
一次加高压,直接把 cell 写成目标状态。
而是采用一种 Program + Verify 的方式。
原因很简单:
它并不知道每次加电压到底能打进去多少电子。
所以真实的做法是:
先打一次 program 脉冲
然后 verify 一下当前电压
如果还没到目标阈值,就再打一小次
再 verify
如此反复,直到超过目标阈值为止
你可以把它理解成往一个水桶里加水。
假设水桶高 20cm,我们的目标不是加满,而是:
只要水位超过 10cm 就算成功
那真实过程就不会是“一次灌到 10cm”。
而更像是:
先倒一点
用尺子量一下
不够,再倒一点
再量一下
直到超过 10cm 为止
NAND Program 的感觉就和这个非常像。
所以它更像是一个:
逐步逼近目标阈值 的过程
而不是一个“一步到位”的过程。
那为什么最后的电压会形成一个分布?
理解这一点,先要搞清楚一个反例。
假设一个 page 里的那 131072 个 cell 是完全一模一样的。
这种“完全一样”包括:
每个 cell 的初始状态完全一样
每个 cell 的氧化层厚度完全一样
每个 cell 的电容完全一样
每个 cell 对每次电压脉冲的响应完全一样
Verify 判断完全没有误差
周围环境完全一样
温度完全一样
噪声完全一样
如果这些条件全部成立,那么最后 program 结束时,这 131072 个 cell 的阈值电压就会完全一样。
那这时候,如果你去统计:
横轴:Vth
纵轴:cell 数量
最后看到的就不是一个山包,而应该是一个 点。
因为所有 cell 都落在同一个电压上。
但现实中的 NAND,不可能做到每个 cell 都一模一样
真实世界里,NAND 的制造工艺不可能把所有 cell 做到完全一致。
这些差异虽然非常小,但在 NAND 这种极其敏感的模拟存储器里,会被放大到阈值电压上。
我把这些原因分成三类。
1. 工艺差异
比如说:
隧穿氧化层厚一点、薄一点
沟道长度有轻微差别
掺杂浓度有轻微差别
浮栅尺寸有轻微差别
电容耦合比有轻微差别
这些差异单独看都很小,甚至小到工艺上觉得“很正常”。
但 NAND program 本来就是一个非常细腻的模拟过程,所以这些微小差异最后都会反映到 (Vth) 上。
你可以把它理解成:
同样打一拳,
有的 cell “涨 0.15V”
有的 cell “涨 0.18V”
有的 cell “涨 0.12V”
同样的 program脉冲,最后每个 cell 的响应其实是不一样的。
2. 电子注入本身就是随机的
电子不是整整齐齐排队进去的。
Program 依赖的是高电场下的电子隧穿,而隧穿这件事本身就带有统计随机性。
换句话说:
即使两个 cell 完全一样,在某一次脉冲下,实际打进去的电子数也可能不完全一样。
它不是那种:
精确地放进去 100 个电子。
而更像是:
平均大概会放进去这么多,但每次都会有波动。
这就会让每次脉冲带来的Vth出现离散。
3. 初始状态也不是完全一样
即使在 program 开始之前,这些 cell 都处于 erased 态,它们的起点也往往不是完全重合的。
有的 cell 初始 (Vth):
更靠左一点
有的更靠右一点
所以即使后面受到相同的 program 条件,最后的终点也不会完全一样。
这就像一群人参加 100 米跑:
有的人起跑线偷偷往前 2 厘米
有的人往后 2 厘米
最后大家冲线的位置,当然不可能整整齐齐在同一个点上。
为什么有 Verify 之后,结果还不是一个点?
你可能会想:
不是每打一轮都 verify 吗?
不是已经测了吗?
那为什么还不能把所有 cell 都测到完全一致?
答案是:
Verify 只能保证“进入目标窗口”,不能保证“停在完全同一个位置”。
用“停车”来理解 Verify
假设现在有 10000 辆车要停进同一个停车位区域。
规则是:
只要车头进到白线以内,就算合格
一旦合格,立刻停车
那最后会发生什么?
有的车:
刚刚压线
有的停得靠前一点
有的停得靠后一点
有的已经进去一大截
但它们都算“停进去了”。
这就是 Verify 的本质。
Program + Verify 真正做的,不是“写成同一个值”
Program + Verify 真正做的事情并不是把所有 cell 精准写到 4.00V(假设4.00V是阈值电压)。
而是:
只要这个 cell 的 Vth 达到目标门限以上,就停止继续写,所以最后自然会出现:
有的 cell 刚刚到线
有的 cell 稍微多一点
有的 cell 多很多一点点
于是,最后这一大群 cell 的电压就形成了一段范围。
而不是一个点。
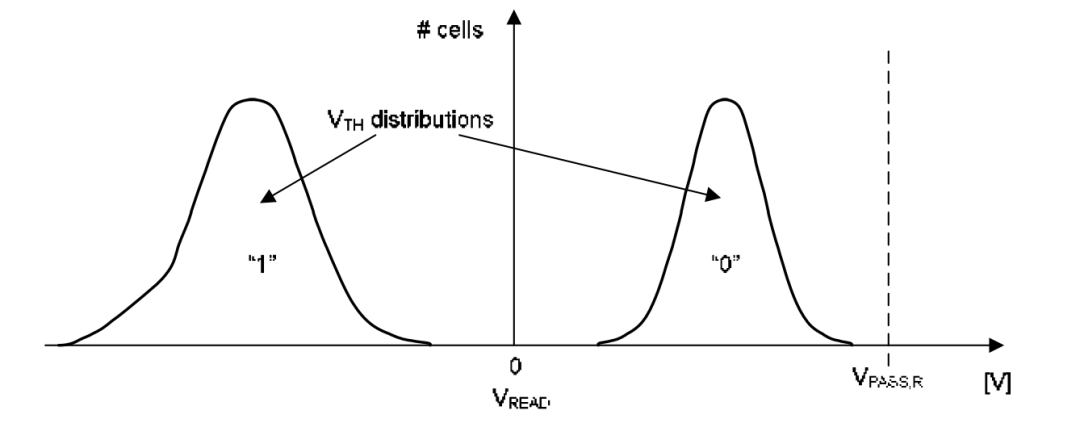
这段范围统计起来,通常就会呈现出一个中间多、两边少的形状,也就是我们常看到的“类似正态分布”的图。
所以这个“分布”到底是什么?
这里一定要再强调一下,因为很多初学者容易误会。
这个分布不是单个 cell 的分布,而是很多个 cell 放在一起统计出来的分布。
对单个 cell 来说,在某一个时刻,它只有一个实际的阈值电压值。
比如:
2.31V
3.02V
1.87V
它本身不是一座山。
真正的“山包图”是这样来的:
把一个 page 里的很多个 cell 都 program 到同一个状态
然后统计这些 cell 的 Vth
看看有多少个落在 2.8V 附近
有多少个落在 2.9V 附近
有多少个落在 3.0V 附近
最后才画出一个电压分布图。
所以图里的纵轴一般写的是:
# of cells
也就是:
在这个电压附近,有多少个 cell。
为什么这个问题这么重要?
因为 NAND 的读取,本质上不是“直接读出 0 和 1”。
而是:
拿一个参考电压去判断,这个 cell 当前的 Vth 落在哪个区间。
如果 program 后每个状态都是一个点,读取会非常简单。
但真实情况不是点,而是一团分布。
而且随着:
P/E 次数增加
Retention 变差
Program Disturb
Read Disturb
这些分布还会继续漂移、变宽、靠近,甚至重叠。
这时候 read、read retry、ECC 才变得有意义。
所以如果 program 之后的分布这件事没想明白,后面的 NAND Read 和 Read Retry 其实很难真正看懂。
总结
NAND program 完成之后,电压之所以会形成一个类似正态分布的图,不是因为单个 cell 自己会“长成一座山”,而是因为:
一个 page 里有大量 cell
每个 cell 的工艺、响应、初始状态都不完全一样
电子注入本身也存在随机性
Verify 只能保证进入目标窗口,不能保证所有 cell 停在完全同一个点
所以最后:
很多个被 program 到同一状态的 cell,会围绕目标阈值形成一个分布。
这就是为什么我们在 NAND 资料里,看到 program 之后的 Vth 通常不是一个点,而是一团分布。
而理解了这一点之后,后面再去看:
NAND Read
Read Retry
ECC
TLC / QLC 的读取复杂性
就会顺很多。
 Alipay
 Wechat